
|
|||
| $ whoami --team ❯ kt cloud 플랫폼엔지니어링팀 김지웅 님 |
1. 들어가며 — 통합은 "한 번 붙이고 끝"이 아니다
최근 인프라 환경은 한 방향으로 움직이고 있습니다. 멀티클라우드와 컨테이너가 확산되면서 관측해야 할 대상은 빠르게 늘고, 그만큼 모니터링·관측(Observability) 도구도 함께 증식합니다. 동시에 운영 인력은 그 속도를 따라가기 어려워, "여러 소스의 이벤트를 한 곳에서 받아 자동으로 처리하는" 통합 운영에 대한 요구가 커지고 있습니다. 이 글이 다루는 "이기종 데이터 통합"이 지금 중요한 이유입니다.
인프라 규모가 커지면 모니터링 도구도 함께 늘어납니다. 가상 서버는 A 시스템이, 네트워크 장비는 B 시스템이, 새로 들어온 컨테이너 플랫폼은 또 다른 관측 플랫폼이 봅니다. 운영자는 결국 창을 여러 개 띄워 놓고 머릿속에서 이벤트를 통합합니다.
그래서 많은 팀이 통합관제 시스템을 만듭니다. 서로 다른 소스의 이벤트를 한 곳에서 받아, 인지 → 조치 → 종료까지 잇는 시스템이죠. 그런데 이런 시스템의 진짜 난이도는 "첫 통합"이 아니라 "그다음" 에 있습니다. 모니터링 도구는 앞으로도 계속 늘어나기 때문입니다. 통합 서비스는 새 소스를 끊임없이 흡수해야 하는 운명입니다.
이 글은 그 "그다음"에 대한 이야기입니다. 저희는 잘 돌아가던 통합관제 시스템에 네 번째 이벤트 소스(새 관측 플랫폼)를 붙였습니다. 그 과정에서 어떤 확장은 놀랄 만큼 쉬웠고, 어떤 확장은 예상치 못한 곳을 무더기로 흔들었습니다. 그 차이가 이 글의 핵심입니다.
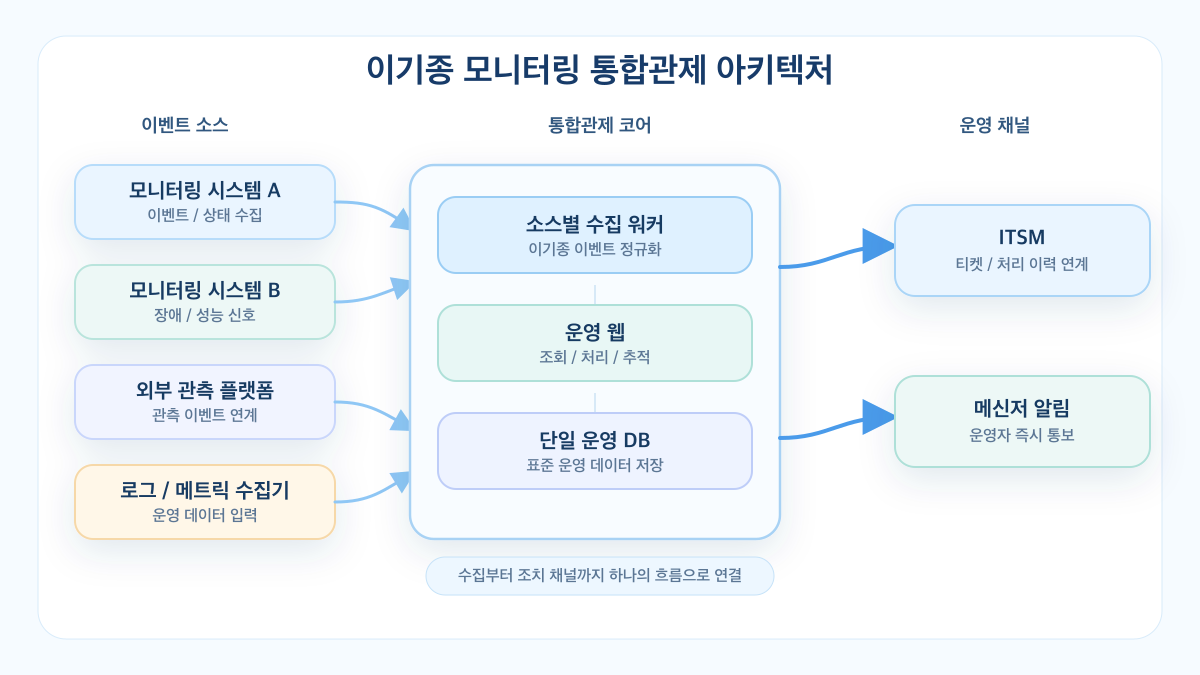
구조 자체는 단순합니다. 여러 이벤트 소스를 받아(좌), 통합관제 코어가 수집·저장하고(중), 운영 채널로 내보냅니다(우). 진짜 난이도는 이 구조에 새 소스가 계속 더해질 때 드러납니다.
2. 한 프로젝트, 두 장면
장면 1 — 수집 워커: 어댑터 하나로 끝났다
새 소스용 수집 워커를 추가하는 작업은 의외로 간단했습니다. 기존 수집 로직이 추상 워커로 묶여 있었기 때문입니다. 소스별 차이(인증, 페이로드 파싱)는 구현체 한 개로 격리돼 있었고, 재처리·순서 같은 공통 정책은 추상 레이어가 이미 책임지고 있었습니다. 새 소스는 "어댑터 한 겹"만 추가하면 됐습니다.
장면 2 — 인벤토리: 화면 곳곳이 흔들렸다
문제는 데이터를 어디에 담고, 어떻게 찾느냐 였습니다.
기존 인벤토리는 IP를 기준 키로 삼고 있었습니다. 그런데 새 소스가 가져오는 데이터 중 서비스·플랫폼 단위는 IP가 아니라 "이름 + 리전" 으로 식별됐습니다. 기준 키 자체가 다른 데이터가 들어온 겁니다.
처음 생각은 "새 인벤토리 테이블 하나만 추가하면 끝" 이었습니다. 실제로는 전혀 아니었습니다. 그 인벤토리를 조인하던 모든 화면·기능의 쿼리가 영향 범위에 들어왔습니다.
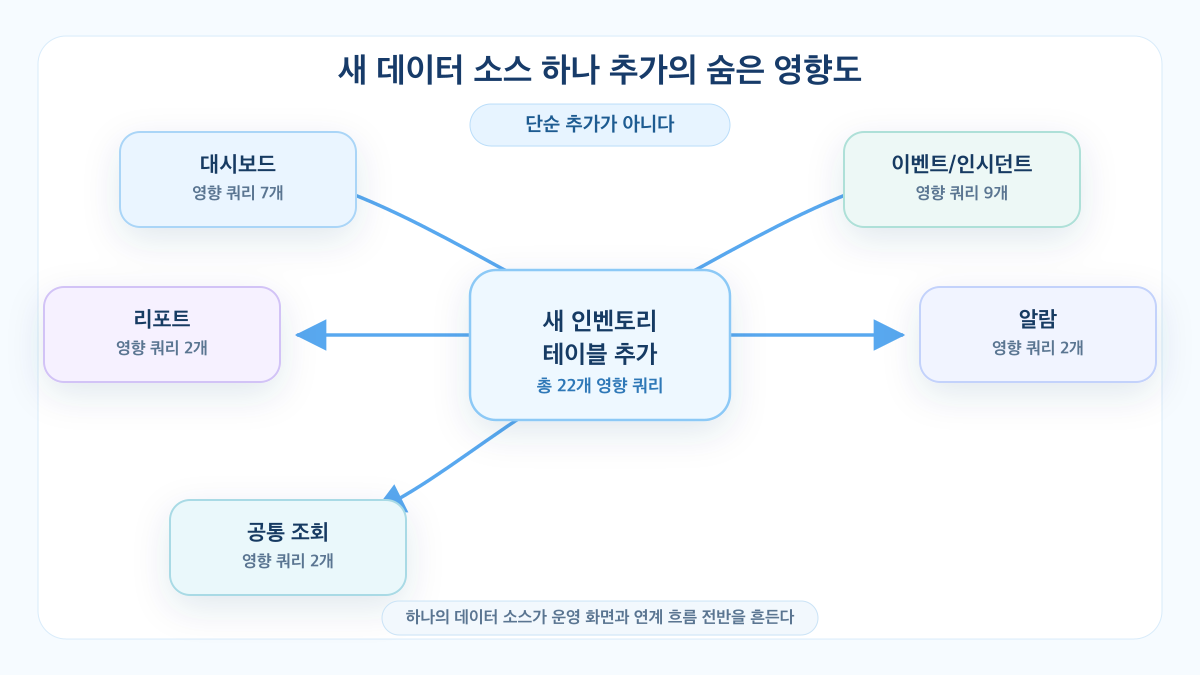
영향 범위는 대시보드, 이벤트/인시던트, 알람(점검·예외), 공통 조회, 리포트까지 운영 화면 전반에 걸쳐 있었습니다.
이 화면들을 손대지 않으면? 데이터는 정상적으로 들어오는데, 운영 화면 어디에도 보이지 않습니다. 동작은 하지만 운영은 안 되는, 가장 찾기 어려운 종류의 문제가 됩니다.
같은 프로젝트, 같은 규모의 "새 소스 추가"인데 한쪽은 어댑터 하나로 끝나고 한쪽은 화면 곳곳을 흔들었습니다. 무엇이 이 차이를 만들었을까요?
3. 차이의 정체 — 자주 바뀌는 지점을 미리 격리했는가
답은 단순합니다. 수집은 "변할 것"을 예상하고 경계(추상 워커)로 격리해 뒀고, 식별과 소비는 그러지 못했습니다.
통합 서비스에서 자주 바뀌는 지점은 거의 정해져 있습니다.
- 새 소스가 들어온다 (수집)
- 그 소스는 다른 식별 키·속성을 쓴다 (식별)
- 새 화면·통계가 그 데이터를 다르게 본다 (소비)
이 세 지점을 데이터가 흐르는 3구간으로 보면, 각 구간이 곧 하나의 격리 경계가 됩니다.
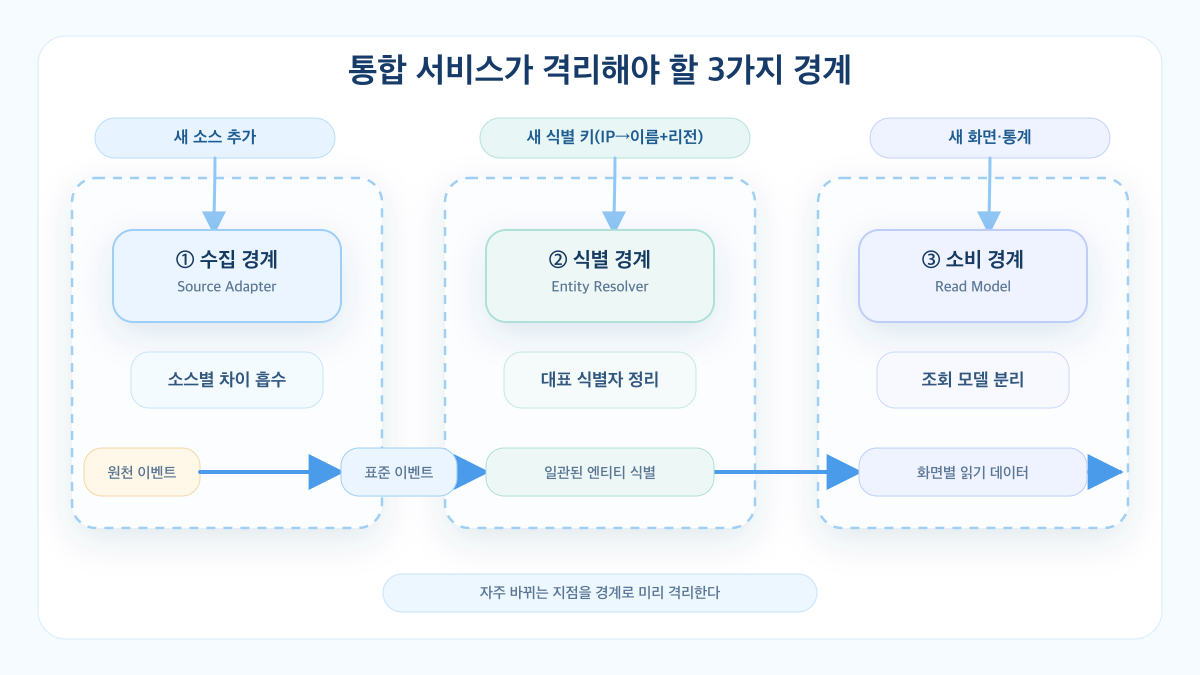
왼쪽에서 받아(수집), 가운데에 담고(식별·저장), 오른쪽으로 내보냅니다(소비). 변화는 이 세 구간에서 들어오므로, 각 구간을 추상화 경계로 미리 막아두면 변화가 그 경계 안에서 흡수됩니다. 막아두지 않으면, 변화는 경계를 넘어 시스템 전체로 번집니다 — 우리 사례처럼.
여기서부터가 이 글에서 가져가실 부분입니다.
4. 통합 서비스 설계의 3가지 경계 (체크리스트)
이기종 통합을 받을 기존 서비스를 설계·점검할 때 아래 3가지를 미리 확인하세요. 우리는 ①만 갖춰져 있었고, ②③이 없어서 화면 곳곳을 고쳤습니다.
① 수집 경계 — Source Adapter
자주 바뀌는 것: 소스의 종류 (새 모니터링이 계속 추가됨)
핵심 질문
- 새 소스 추가가 "어댑터 1개 추가"로 끝나는가?
- 코어 로직이 소스별 분기(if source == ...)를 직접 알고 있지 않은가?
- 재처리·순서·중복 제거 같은 공통 정책이 소스마다 흩어져 있지 않은가?
우리 사례 — 추상 워커로 이미 격리돼 있어, 새 소스는 어댑터 한 겹만 추가하면 됐습니다. 수집 방식도 실시간 Push 대신 단조 증가 커서 기반 Pull로 통일해, "마지막 지점부터 다시"가 자명하도록 공통화했습니다.
안 했을 때 — 소스마다 수집 로직을 복붙하게 되고, 재처리·순서 정책이 제각각이 되어 장애 복구가 소스별로 달라집니다.
② 식별 경계 — Entity Resolver
자주 바뀌는 것: 엔티티를 식별하는 키와 속성 (IP, 이름+리전, …)
핵심 질문
- 식별 키가 소스마다 달라도, 조회하는 쪽은 한 가지 방식으로 엔티티를 찾는가?
- 키 매칭 로직이 개별 화면 쿼리마다 흩어져 있지 않고 한 곳(Resolver) 에 모여 있는가?
- 소스 고유 속성을 코어 컬럼에 욱여넣는 대신 공통 필드 + 확장(JSONB) 으로 분리했는가?
우리 사례 — 여기에 경계가 없었습니다. IP 매칭이 모든 조회 쿼리에 직접 박혀 있었기 때문에, "이름+리전"이라는 새 키가 들어오자 그 쿼리들을 전부 고쳐야 했습니다. 이것이 그 광범위한 영향의 정체입니다. (소스의 메타데이터 자체는 JSONB로 손실 없이 보존해, 속성 확장에는 강했습니다.)
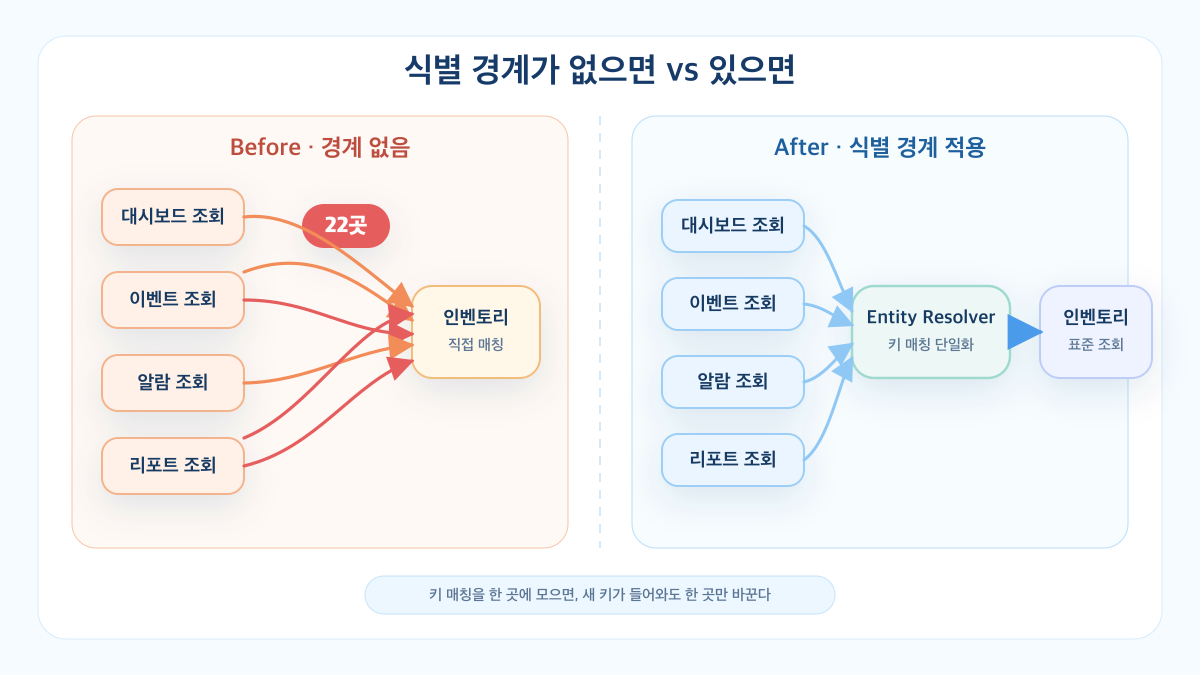
식별 경계(Resolver)를 한 겹 뒀다면, 새 키가 들어와도 그 한 곳만 고치면 됐을 일입니다. 경계가 없으니 키의 차이가 조회 코드 전역으로 새어 나간 것입니다.
안 했을 때 — 새 식별 키 하나가 조회 쿼리 전수 수정으로 번집니다. 영향 범위가 코드 전역에 퍼져, "이게 다인가?"를 끝까지 확신하기 어렵습니다.
③ 소비 경계 — Read Model
자주 바뀌는 것: 데이터를 보는 화면·통계 (대시보드/이벤트/인시던트/리포트…)
핵심 질문
- 화면·통계가 코어 테이블을 직접 조인하는가, 아니면 read model(뷰/전용 조회 모델)을 경유하는가?
- 코어 테이블 하나를 바꿨을 때, 깨지는 화면이 몇 개인지 셀 수 있는가?
- 조회 패턴이 다른 화면들을 같은 코어 쿼리로 억지로 묶고 있지 않은가?
우리 사례 — 화면들이 코어 테이블을 직접 조인하고 있어서, 인벤토리 구조 변경이 곧바로 화면 곳곳으로 전파됐습니다. 소비 측을 read model로 한 겹 떼어놨다면 충격이 그 레이어에서 흡수됐을 것입니다.
안 했을 때 — 코어의 작은 변경이 화면·통계 전반으로 번지고, "데이터는 들어왔는데 화면엔 안 보이는" 침묵의 버그가 생깁니다.
5. 3경계가 작동하려면 — 공통 약속
세 경계는 공통 약속 위에서만 제대로 동작합니다. 경계를 그어도 약속이 없으면 경계가 새기 때문입니다.
- 인터페이스 계약: 소스와의 계약(단조 증가 커서, 발생/해소 페어링 보장)을 한 문장으로 합의해 두면, 보정 코드가 양쪽에서 증식하지 않습니다. 우리는 이 한 문장 합의가 수집 코드를 절반으로 줄였습니다.
- 코드값 사전: 소스/타입/상태 코드값 컨벤션(대소문자·약어)을 문서로 둬야 합니다. 없으면 신규 개발자가 운영 DB를 역추적해야 실제 값을 압니다.
- 문서-구현 정합: 설계 스키마와 실제 컬럼이 어긋나면(drift) 경계의 신뢰가 무너집니다. 스키마는 단일 출처에서 관리하세요.
- 운영 가시화: 식별 경계에서 매칭에 실패한 데이터는 버리지 말고 별도 채널로 노출하세요. 조용한 유실이 가장 위험합니다.
6. 공통화의 함정 — 멈출 줄도 알아야 한다
오해를 막기 위해 분명히 해두겠습니다. 체크리스트의 목적은 "전부 공통화"가 아니라 "어디를 공통화하고 어디는 두는지 의식적으로 결정" 하는 것입니다.
이 문제를 고칠 때, 저희는 두 가지 길을 검토했습니다.
| 방안 | 내용 | 판단 |
| 통합 뷰 (전면 공통화) | 뷰 한 겹으로 모든 쿼리를 묶음 | 쿼리마다 필요 컬럼·조인이 달라 성능·복잡도가 오히려 증가 |
| 개별 UNION (부분 대응) | 각 쿼리 컨텍스트에 맞춰 개별 봉합 | 손은 많이 가지만 안전 |
저희는 개별 UNION을 택했습니다. 한 겹의 추상화로 묶는 것이 항상 정답은 아닙니다. 추상화 경계는 "자주, 같은 방식으로 변하는 지점"에 긋는 것이지, 모든 중복에 긋는 게 아닙니다. 변화의 축이 분명한 곳(소스·식별·소비)에 경계를 두고, 컨텍스트가 제각각인 곳은 개별 대응으로 남겨두는 판단 — 이 균형이 핵심입니다.
7. 적용 후 — 경계 관점이 바꾼 것
영향받은 화면을 모두 손본 뒤, 새 소스의 이벤트는 기존 소스와 구분 없이 동일한 검색·필터·권한·대응 체계 안에서 다뤄지게 됐습니다. 외부에서 받은 이벤트가 우리 인벤토리·권한·조직 체계에 그대로 녹아든 것입니다. 운영자 입장에서는 "새 소스가 추가됐다"는 사실을 의식할 필요조차 없어졌습니다 — 통합이 지향하는 건 바로 이 "보이지 않는 흡수" 입니다.
더 큰 변화는 일하는 방식에 있었습니다. 이 경험을 계기로 수집·식별·소비 3경계 점검을 설계 단계의 표준 체크리스트로 삼았습니다. 새 소스나 새 식별 키가 논의될 때 "이 변화가 어느 경계에서 흡수되는가"를 먼저 묻게 됐고, 영향 범위를 코드를 다 짠 뒤가 아니라 설계 시점에 가늠할 수 있게 됐습니다. 정량적으로 환산하기는 어렵지만, "동작은 하는데 운영 화면엔 안 보이는" 종류의 사고를 구조적으로 줄였다는 것이 가장 큰 소득입니다.
8. 마치며 — 설계 단계에 3경계 점검을
새 소스 하나를 붙이는 일은 "워커 하나 추가"로 끝나지 않았습니다. 하지만 그 과정에서 통합 서비스가 어디까지 변화에 견디는지, 어디를 더 단단히 해야 하는지가 분명해졌습니다.
이기종 데이터를 통합하는 서비스를 설계한다면, 코드를 짜기 전에 수집·식별·소비 세 경계가 갖춰져 있는지부터 점검하시길 권합니다. 모니터링 도구는 앞으로도 계속 늘어날 것이고, 중요한 건 도구의 개수가 아니라 그것들을 흔들림 없이 흡수할 구조입니다. 운영 중단이 비즈니스에 미치는 영향이 클수록, 이 "흡수 능력"의 가치는 커집니다.
❓ FAQ
Q1. 세 경계를 처음부터 다 갖추면 과설계 아닌가요?
핵심은 '변화의 축이 분명한가'입니다. 통합 서비스에서 새 소스 유입, 새 식별 키, 새 조회 화면은 '혹시'가 아니라 '언젠가 반드시' 들어오는 변화입니다. 그래서 세 경계는 미래에 대한 투기가 아니라 예측 가능한 변화에 대한 선제 투자입니다. 반대로 변화 축이 불분명한 중복까지 추상화하면 복잡도만 늘어 오히려 과설계가 됩니다. 6장에서 전면 공통화 대신 컨텍스트가 제각각인 조회를 개별 대응으로 남긴 이유가 그것입니다 — 경계는 '어디를 묶고 어디를 남길지 의식적으로 결정'하는 도구입니다.
Q2. 식별 경계가 없으면 왜 영향 범위가 그렇게 넓어지나요?
식별 키 매칭 로직이 한 곳(Resolver)에 모이지 않고 개별 조회 쿼리마다 직접 박혀 있으면, 새 식별 키 하나가 들어올 때 그 키를 참조하던 조회들이 동시에 수정 대상이 됩니다. 영향이 코드 전역으로 퍼지면 '이게 전부인가'를 끝까지 확신하기 어렵고, 누락된 한 곳은 데이터는 들어오는데 화면엔 보이지 않는 침묵의 버그가 됩니다. 반대로 Resolver 한 겹이 있으면 키의 차이가 그 안에서 흡수되어, 조회 측은 언제나 한 가지 방식으로 엔티티를 찾습니다.
Q3. 실시간 Push 대신 폴링(Pull)을 택한 이유는?
재처리와 순서 보장 때문입니다. 단조 증가 커서 기반 Pull은 '마지막 처리 지점부터 다시'가 자명해 장애가 나도 복구 지점이 명확합니다. Push는 순간 처리량은 유리하지만 유실·순서 꼬임이 생기면 어디부터 다시 처리할지가 모호해집니다. 이벤트 누락이 곧 운영 사고로 이어지는 통합관제 도메인에서는, 약간의 폴링 지연을 감수하더라도 복구의 단순함이 더 큰 가치였습니다.
Q4. 외부 소스 연동에서 코드 외적으로 자주 놓치는 건?
인증서(SSL/PKIX) 설정과 이벤트 페어링(발생/해소) 정책입니다. 둘 다 코드가 아니라 '합의와 환경'의 영역이라 개발 일정에서 빠지기 쉽습니다. 인증서는 특히 사내망·폐쇄망 구간에서 자주 막히고, 발생/해소 페어링 규칙이 어긋나면 종료되지 않는 유령 이벤트가 쌓입니다. 그래서 이 둘은 코드 리뷰가 아니라 배포 절차서 체크리스트에 명시해 환경·합의 항목으로 관리하길 권합니다.
Q5. 이 3경계는 우리 서비스에만 해당하나요, 다른 통합에도 적용되나요?
수집·식별·소비는 특정 기술 스택이 아니라 '데이터가 흐르는 방향'에 기반한 구분이라, 이기종 통합 전반에 일반화됩니다. 모니터링 통합이든 로그·메트릭 통합이든, 새 소스가 계속 유입되는 구조라면 동일하게 점검할 수 있습니다. 중요한 건 도구의 종류가 아니라 '새로운 것을 어느 경계에서 흡수하는가'라는 질문 그 자체입니다.
Q6. 이미 경계 없이 만들어진 기존 시스템은 어떻게 통합·유지보수 가능한 체계로 바꾸나요?
한 번에 다 갈아엎기보다 '가장 자주 바뀌는 경계부터' 점진 도입하는 것이 현실적입니다. ① 먼저 변경이 코드 전역으로 번지는 지점(우리의 경우 식별 키)을 찾아 '여기에 경계가 빠졌다'고 진단합니다 — 영향 범위가 넓게 퍼진다는 사실 자체가 경계 부재의 신호입니다. ② 그 지점에 Resolver나 Read Model 같은 얇은 경계 레이어를 한 겹 끼우되, 기존 코드는 그대로 두고 새 유입부터 경계를 경유하게 합니다(스트랭글러 패턴). ③ 기존 조회는 급히 전부 바꾸지 않고, 전면 공통화가 손해인 곳은 개별 대응으로 남기며 흡수 범위를 의식적으로 넓혀 갑니다. 핵심은 빅뱅 리팩터링이 아니라, 변화가 새는 지점을 신호 삼아 경계를 하나씩 끼워 넣어 '다음 변화부터' 흡수되게 만드는 것입니다. 여기에 코드값 사전·문서-구현 정합·매칭 실패 데이터의 운영 가시화(5장)를 함께 두면, 레거시의 숨은 부채가 조용히 쌓이지 않고 드러납니다.
?› 자주 묻는 질문 FAQ
📚 관련 / 출처REFERENCES
'Tech Story > Cloud Architecture' 카테고리의 다른 글
| [구축사례] kt cloud PLATFORM Observability Alert 플랫폼 구축하기 (0) | 2026.08.20 |
|---|---|
| [구축사례] 흩어진 운영 데이터를 하나로, kt cloud 운영 데이터 통합 플랫폼 Deck 구축기 (0) | 2026.08.06 |
| [기술사례] OVN ACL Flow Sampling 기반 VPC Flow Log 서비스 개발 (0) | 2026.07.31 |
| [구축사례] IPFIX와 Goflow2로 구현한 kt cloud Network 미터링 내재화 (0) | 2026.07.24 |
| [구축사례] kt cloud PLATFORM OpenStack 검증용 Zuul.CI Gating System 구축 (0) | 2026.07.16 |