
요약 SUMMARY
AI로 만든 자동화 도구를 유지보수 가능한 구조로 설계하는 과정을 다룹니다.
암묵지를 데이터로 분리해 자동화 부채를 줄이고 팀 단위 시스템으로 발전시키는 방법을 정리합니다.
#AI자동화 #업무자동화 #암묵지 #자동화부채 #관심사의분리
안녕하세요! 😀
작년부터 AI가 빠르게 일상 속으로 들어오면서, 자연스럽게 이런 생각이 들기 시작했습니다.
"우리 팀의 업무에도 AI를 본격적으로 써볼 수 있지 않을까?"
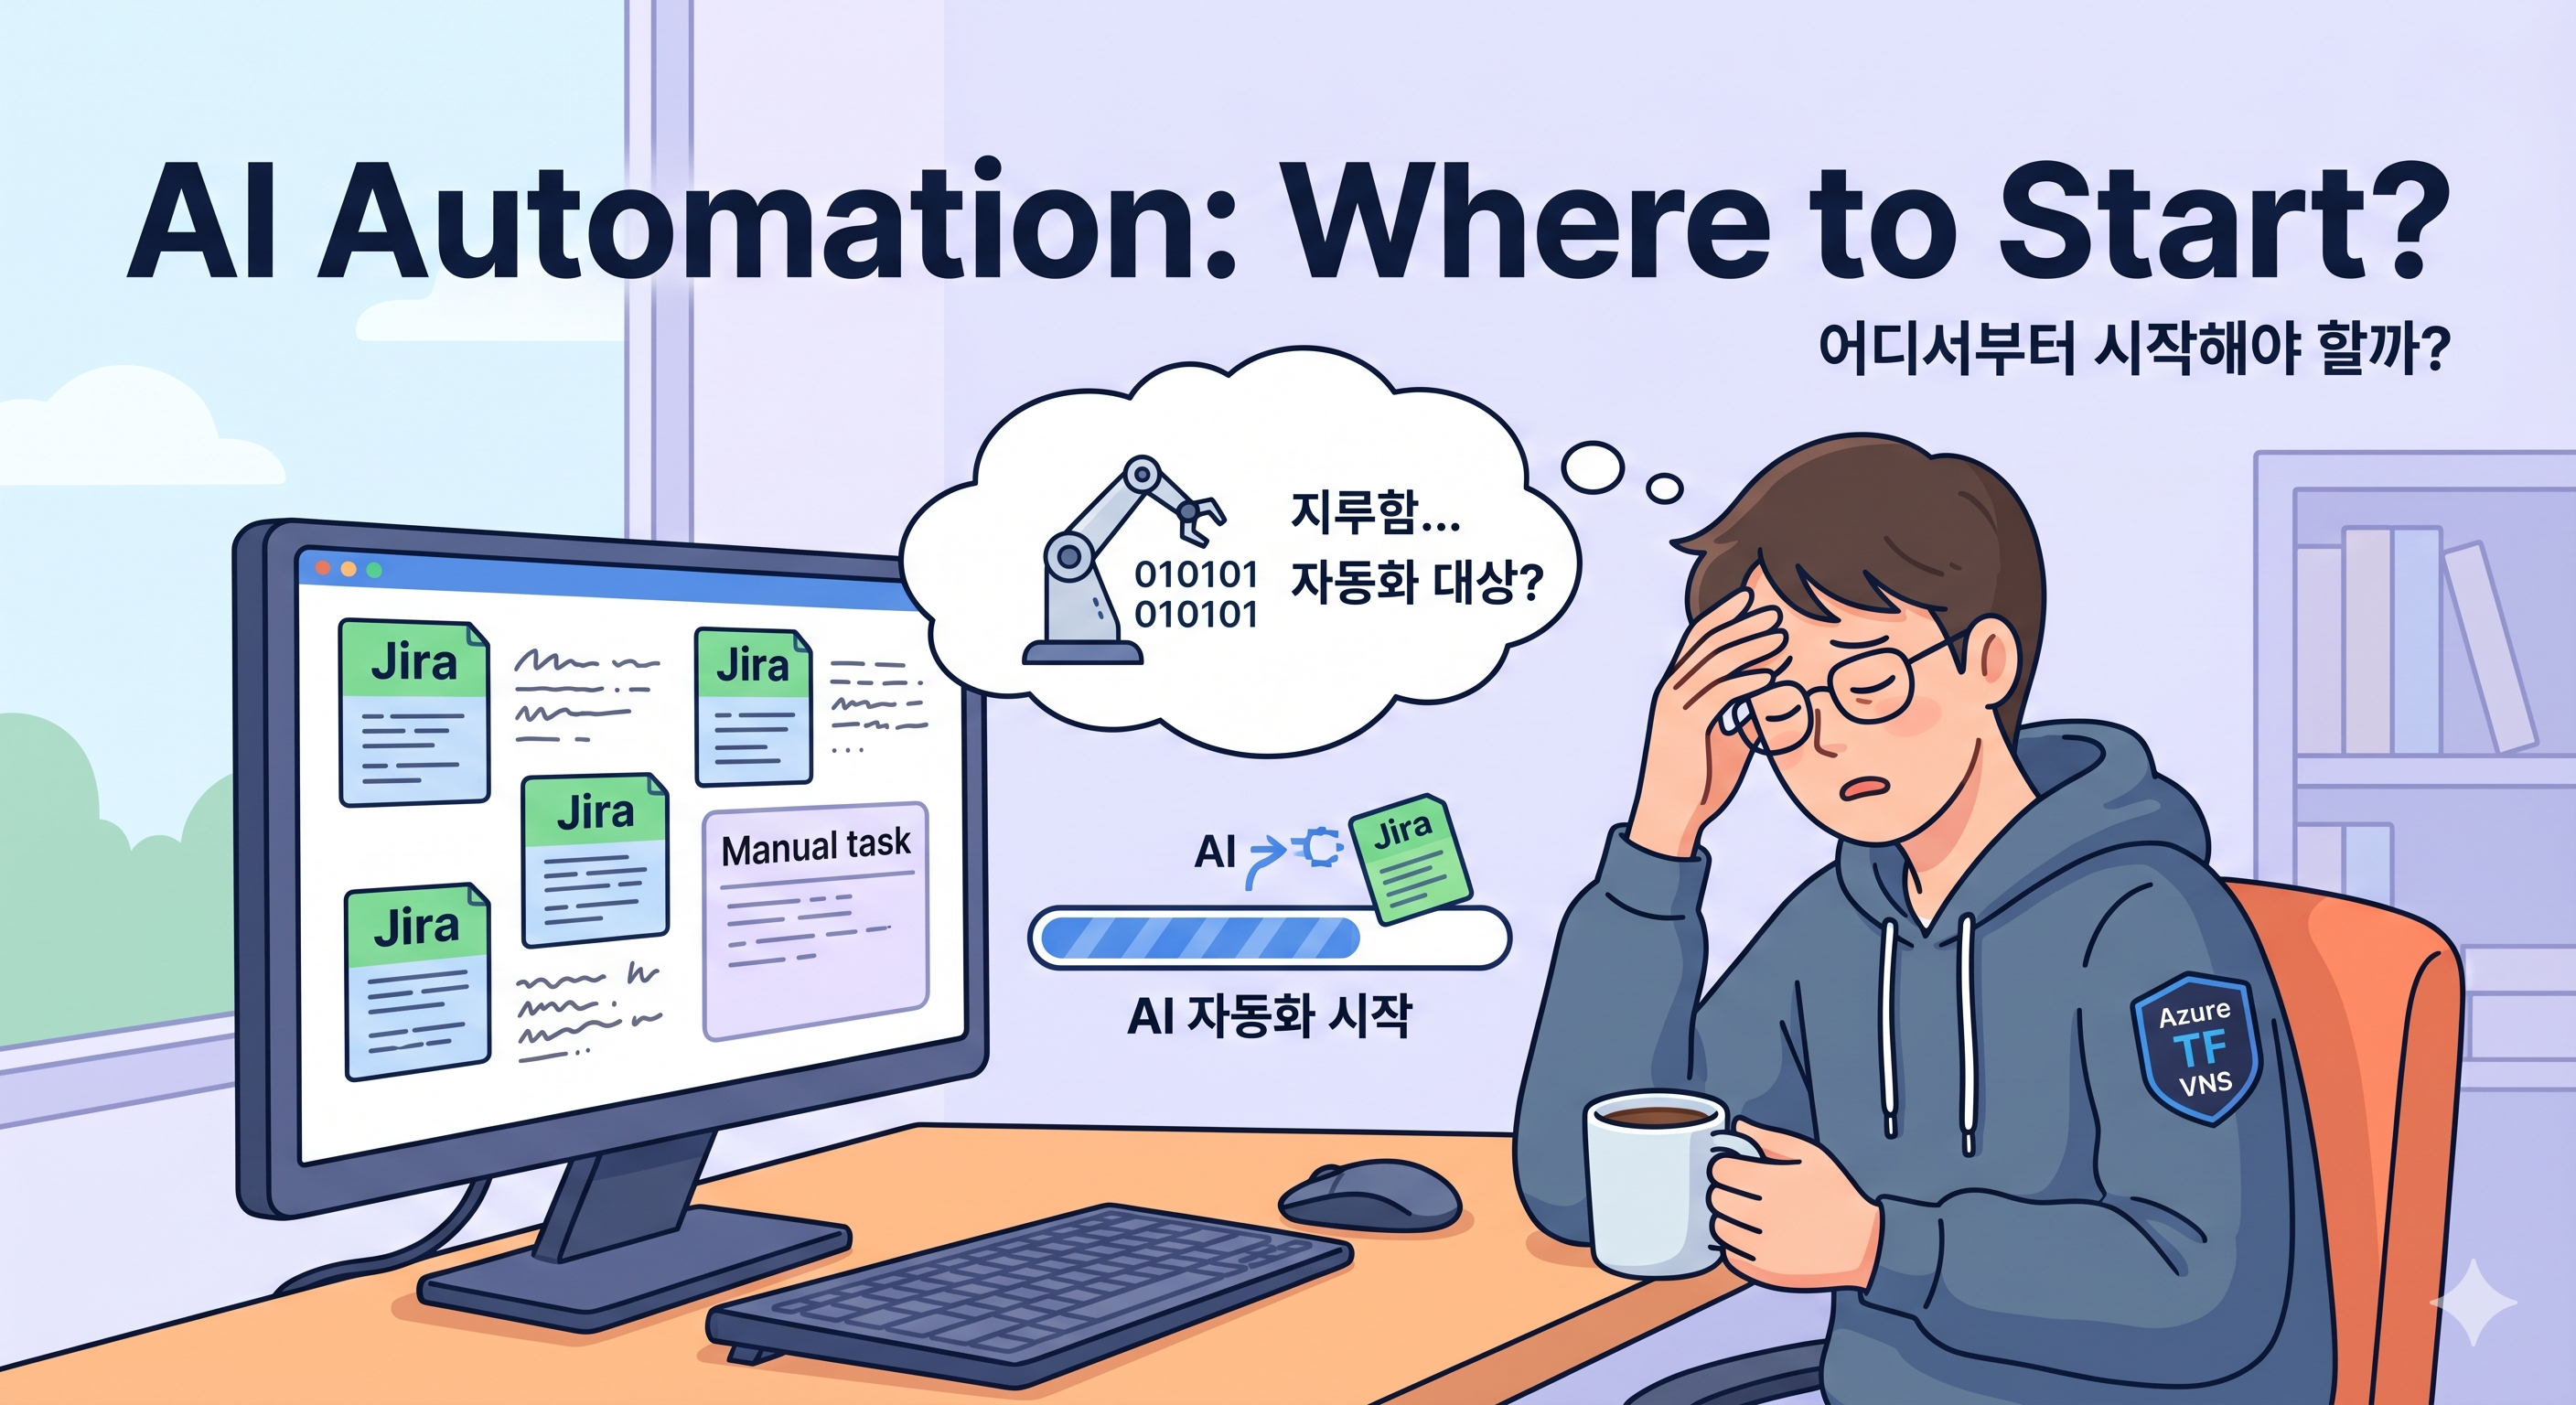
최근 전사적인 클라우드 전환이 가속화되면서 저희 팀으로 쏟아지는 인프라 구축 및 권한 요청의 수는 기하급수적으로 늘어나고 있었습니다. 처음에는 단순히 ChatGPT나 Claude로 인프라 설계를 물어보거나 CLI 문법을 체크하는 보조 도구 수준에서 AI를 활용했습니다. 그러다 점차 "이렇게 똑같은 패턴으로 매일 반복되는 파이프라인 자체를 시스템으로 자동화할 수 있지 않을까?" 하는 욕심이 생겼습니다.
1. 첫 번째 질문: 무엇을 자동화할 것인가?
자동화를 시작하려면 가장 먼저 해야 할 일이 있습니다. 단순 반복 업무가 무엇인지 정의하는 것입니다.
이게 생각보다 쉽지 않습니다. 그 이유가 뭘까 생각해봤는데, 결국 암묵지(Tacit Knowledge) 문제였습니다. 매일 반복하다 보면 "원래 이렇게 하는 거야"로 굳어버립니다. 의식하지 않고 몸이 먼저 움직이는 것들, 그게 암묵지입니다. 자동화 대상이 보이지 않는 게 아니라, 너무 익숙해져서 "업무"로 인식조차 안 되는 것입니다.
저희 팀의 일과를 하나씩 매의 눈으로 뜯어보았습니다. 매일 사내 요청 접수 채널에 들어오는 수많은 상세 내용을 확인하고, 화면을 이리저리 오가며 정보를 파악한 뒤, 이를 팀 내 작업 관리 도구(이슈 트래커)에 일일이 옮겨 적는 일이 반복되고 있었습니다.
"요청 정보 복사해서 붙여넣기, 항목별로 찾아서 또 복사해서 붙여넣기..."
"이 정보들을 종합해서 10개가 넘는 이슈 트래커 관리 항목에 일일이 찾아 넣기..."
이 과정은 단순히 지루할 뿐만 아니라 휴먼 에러(Human Error)의 온상이었습니다. 수작업으로 진행하다 보니 어떤 날은 데이터를 누락하기도, 어떤 날은 오타를 내기도 했습니다. 이런 사소한 오타 하나는 나중에 클라우드 리소스를 추적하거나 과금 비용을 정산할 때 엄청난 스노우볼이 되어 돌아옵니다.
이 '지루함'과 '비효율'의 순간을 포착했습니다. 반복적인 데이터 확인과 입력 업무를 스크립트로 처리하여, API를 통해 작업 관리 도구에 자동으로 이슈를 생성해 주는 맞춤형 자동화 도구를 직접 개발해 보기로 했습니다.
암묵지를 끄집어내는 가장 좋은 신호는 "이 작업을 하면서 지겹다는 생각이 드는 순간"입니다. 그 지루함이 암묵지를 명시지로 바꾸는 출발점이고, 자동화의 시작점입니다.
2. 두 번째 질문: AI한테 어떻게 물어볼 것인가?
목표가 명확해졌으니 코드를 작성할 차례입니다. 처음 AI에게 코드를 요청했던 방식은 무척 단순했습니다. 머릿속에 있는 요구사항을 그대로 쏟아내는 방식이었습니다.
"사내 업무 시스템 화면을 스크래핑해서 이슈 트래커 API로 티켓을 생성해줘. 요요청 유형에 따라 필요한 관리 항목을 확인하고, 각각의 필요한 정보를 자동으로 입력해 줘."
AI는 요구사항을 찰떡같이 알아듣고 자바스크립트 코드를 뚝딱 만들어주었습니다. 처음엔 정말 마법 같았습니다. 버튼 하나만 누르면 브라우저가 화면을 읽고 10개가 넘는 복잡한 Jira 필드가 1초 만에 자동으로 채워졌습니다. 수작업에 쏟던 시간이 0으로 수렴하는 듯했습니다.
그러면 해피엔딩이었을까요?
3. 진짜 문제는 그 다음이었습니다
동화처럼 "행복하게 잘 살았습니다"로 끝나면 좋았겠지만, 현실은 달랐습니다.
한번 만들면 끝이 아니었습니다.
회사 내의 업무는 살아 숨 쉬는 유기체와 같습니다. 새로운 서비스가 지속적으로 런칭되고, 기존 서비스의 아키텍처나 보안 등급이 수시로 변경됩니다. 이런 변경 사항을 반영하기 위해 AI가 처음 짜준 코드를 열어본 순간 눈앞이 캄캄해졌습니다.
// AI가 초기에 생성했던 유지보수 불가능한 하드코딩 사례
function mapResourceTag(envCode) {
  let envName = "DEVELOPMENT";
  let costCenter = "DEV-001";

  if (envName === "DEVELOPMENT") {
    costCenter = "DEV-001"; tags = "dev-resource";
  } else if (envName === "PRODUCTION") {
    costCenter = "PRD-999"; tags = "prd-resource";
  } else if (envName === "STAGING") {
    // ... 이런 조건문 로직이 수십 줄 이상 무한정 늘어남
  }
  return { costCenter, tags };
}
AI는 '당장 눈앞에서 돌아가는 결과물'을 만들었을 뿐, 지속 가능한 소프트웨어 구조를 고민해 주지 않았습니다. 비즈니스 로직이 코드 깊숙한 곳에 하드코딩되어 버린 것입니다. 새로운 환경이 추가될 때마다 AI에게 전체 코드를 다시 복사해서 던져주고 "여기에 if문 하나 더 추가해 줘"라고 부탁해야 했습니다.
더 심각한 건 LLM의 컨텍스트 한계(Context Window)였습니다. 코드가 길어지고 대화가 누적될수록 AI는 앞서 지시한 제약 사항을 잊어버리거나 엉뚱한 변수명을 지어내는 환각(Hallucination) 현상을 보였습니다. 결국 AI가 코드를 짜주는 속도보다, 무너져 내리는 스파게티 코드를 직접 디버깅하며 수습하는 데 드는 시간이 훨씬 커졌습니다. 자동화의 편리함보다 유지보수 비용이 기하급수적으로 커지는 '자동화 부채(Automation Debt)' 상태에 빠져버린 것입니다.
4. 구조의 전환: 암묵지를 '데이터'로 꺼내다
이 뼈아픈 경험을 통해 소프트웨어 공학의 오래된 교훈을 다시 한번 깨달았습니다.
AI를 활용한 자동화 역시 "만드는 것"보다 "유지하는 것"을 먼저 고려해서 설계해야 합니다.
그리고 그 전제 조건이 있습니다. 우리 팀의 암묵지를 먼저 시스템이 읽을 수 있는 명시지로 꺼내야 합니다. 머릿속에 파편화되어 있던 매핑 룰을 if-else 형태의 코드가 아닌, 철저히 독립된 '데이터'로 분리해야 했습니다. 이를 개발 용어로는 관심사의 분리(Separation of Concerns) 라고 합니다.
프롬프트의 접근 방향을 완전히 바꿨습니다. AI에게 비즈니스 로직을 짜달라고 하는 대신, "우리가 만든 룰셋 파일을 읽고 매핑만 수행하는 순수 함수(Pure Function) 로직을 짜줘"라고 요청했습니다.
# 리소스 태그 매핑 룰셋 (예시)
환경,비용부서,태그명
DEVELOPMENT, DEV-001, dev-resource
PRODUCTION, PRD-999, prd-resource
이 구조로 뼈대를 개편한 뒤 놀라운 변화가 생겼습니다. 새로운 인프라 환경이 수십 개가 생겨나도, 비용 부서가 바뀌어도 자바스크립트 코드를 한 줄도 건드릴 필요가 없어졌습니다. 최신 정보가 담긴 CSV 파일만 덮어씌워 주면 자동화 도구가 알아서 데이터를 읽고 매핑을 수행했습니다.
이 구조의 가장 큰 장점은 코딩을 전혀 모르는 운영 인력이나 기획자라도 엑셀에서 파일만 수정하면 전체 자동화 시스템의 로직을 안전하게 업데이트할 수 있다는 점입니다. 개인의 장난감 같았던 스크립트가 진정한 의미의 '팀 시스템'으로 진화한 순간이었습니다.
마치며
AI를 통해 개발하면서 제법 깨달은 점도 있었습니다.
자동화가 뜻대로 매끄럽게 돌아가지 않는다고 느껴질 때, 혹은 AI가 짜준 코드를 보며 묘한 답답함을 느낄 때 — 그 근본적인 원인은 AI의 성능 부족이 아닐 때가 많다는 것입니다. 우리 팀의 암묵지를 밖으로 꺼내 명확한 규칙으로 구조화하지 못한 설계 부족 인 경우가 훨씬 많았습니다.
AI 시대를 맞이한 엔지니어는 이제 질문의 차원을 바꿔야 합니다.
- "이 기능을 어떻게 만들까?" → "이 기능이 6개월 후에 바뀌어도 코드를 안 건드리려면 어떻게 설계해야 할까?"
- "AI한테 어떻게 설명하지?" → "우리 팀의 암묵지를 어떻게 CSV, YAML 같은 기계가 읽을 수 있는 데이터로 정리할까?"
자동화 도구는 한번 만들고 저장소 구석에 방치해두는 박제된 코드가 아닙니다. 팀의 업무 흐름, 조직의 변화와 함께 호흡하고 유연하게 진화해야 하는 생명체입니다. 그 진화의 무게를 견딜 수 있는 견고한 아키텍처를 처음부터 설계하는 것 — 이것이 엔지니어가 발휘해야 할 진짜 역량일 것입니다.
그렇다면, 이 고민을 로컬 Chrome Extension을 넘어 수많은 개발자가 참여하는 팀 단위의 인프라 코드베이스(IaC)로 확장하면 어떤 일들이 벌어질까요? 쏟아지는 AI 생성 코드들을 어떻게 통제하고 팀의 거버넌스를 유지할 수 있을까요?
다음 글에서는 이 고민의 결과물인 팀 거버넌스 구축과 Harness 기반의 자동화 검증에 대해 이어서 이야기해보겠습니다.
자주 묻는 질문 FAQ
관련 / 출처 REFERENCES
'Tech Story > etc.' 카테고리의 다른 글
| [AI활용] Claude 실무편 - kt cloud VM에서 PR 리뷰 자동화하기 (0) | 2026.08.20 |
|---|---|
| [AI활용] Claude 실무편 - Technical Writer Skill 만들기 (0) | 2026.08.14 |
| [AI활용] AI가 코딩하고, kt cloud AI NEXUS로 AI 서비스를 배포한다 (0) | 2026.08.06 |
| [도입전략] 공공 AI 전환을 위한 AX Readiness Check 활용법 (0) | 2026.07.09 |
| [AI활용] AI 에이전트의 안전벨트, 하네스 엔지니어링: Claude Code와 Terraform 사례 (0) | 2026.07.03 |