
요약 SUMMARY
GPU 자원 동적 할당과 ResourceClaim 활용 방법을 다룹니다.
CDI 기반 장치 주입과 MIG 연계 방식 등 GPU 운영에 필요한 주요 변화를 정리합니다.
#Kubernetes #DRA #GPU스케줄링 #ResourceClaim #CDI
AI/ML 워크로드가 기업 인프라의 핵심으로 자리 잡으면서, GPU 자원을 얼마나 효율적으로 스케줄링하고 관리하느냐가 경쟁력의 척도가 되고 있습니다. Kubernetes 1.34(2025년 8월 출시)는 바로 이 지점에서 중요한 전환점을 마련했습니다.
Kubernetes 1.34 버전 릴리스의 주요 enhancement 중 하나는 DRA(Dynamic Resource Allocation)의 GA 승격입니다.
기존 Device Plugin 방식의 정적이고 경직된 GPU 할당 방식에서 벗어나, 이제는 "메모리 20GB 이상의 GPU 아무거나 주세요" 와 같이 조건 기반의 유연한 자원 요청이 가능해졌습니다. 이는 LLM 학습, 추론 서비스, 멀티테넌트 GPU 공유 등 다양한 시나리오에서 운영 효율을 획기적으로 높여줍니다.
또한 지난 2026년 3월 KubeCon Europe에서 NVIDIA는 GPU용 DRA 드라이버를 CNCF에 기증하며 커뮤니티 주도의 GPU 오케스트레이션 생태계로의 전환을 공식화했습니다.
이 포스팅에서는 Kubernetes 1.34에서 GPU 관련 변화에 대해 자세히 살펴보겠습니다.
핵심 변화
Kubernetes 1.34 에서 본격적인 Feature 변경사항에 대해 설명합니다.
변화 1: DRA (Dynamic Resource Allocation) - 드디어 GA
[DRA란?]
DRA(Dynamic Resource Allocation) 는 resource.k8s.io API 그룹 기반의 Kubernetes 프레임워크입니다.
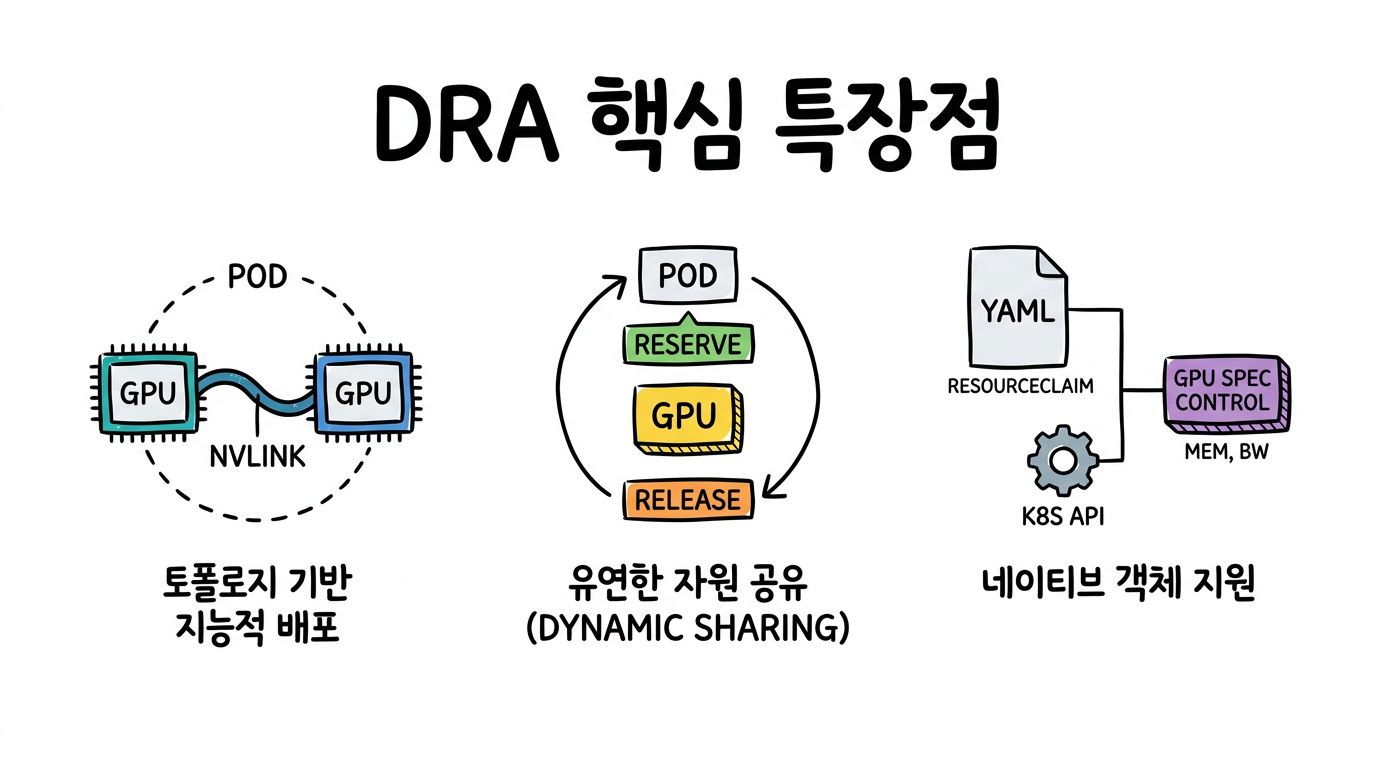
ResourceClaim 이나 ResourceClaimTemplate 리소스를 생성하여 여러 GPU 자원 중 NVLink로 묶인 자원만 Pod에 할당하거나, Pod가 실행될 때만 GPU를 동적으로 예약하는 등 보다 유연하게 활용할 수 있는 특장점을 가집니다.
DRA Driver 사용 시 Kubernetes v1.34.2 이상을 사용하세요. v1.34.0/v1.34.1에는 알려진 이슈가 있습니다.
ResourceClaim / ResourceClaimTemplate
ResourceClaim은 특정 Pod가 실행되기 위해 필요한 하드웨어 자원의 구체적인 명세와 예약 현황을 기록하는 객체이며, ResourceClaimTemplate은 이 ResourceClaim을 동적으로 자동 생성하기 위해 미리 정의해 둔 템플릿입니다.
ResourceClaim 과 Pod는 1:1 바인딩되며 GPU 자원을 락(Lock)을 걸어, Pod에만 독점합니다.
Deployment나 StatefulSet 아키텍처에서는, ResourceClaimTemplate 을 사용하여 Pod replicas 변화될때 마다 자동으로 ResourceClaim 복제본이 생성되도록 사용할 수 있습니다.
[DRA 사용 방법]
- DeviceClass 확인
- NVIDIA GPU Operator 를 설치하면 nvidia.com/gpu 이름의 DeviceClass가 자동 생성됩니다.
# kubectl get deviceclasses
apiVersion: resource.k8s.io/v1
kind: DeviceClass
metadata:
  name: nvidia.com/gpu
spec:
  selectors:
    - cel:
        expression: device.driver == "gpu.nvidia.com"
- ResourceClaim 리소스를 생성
- 사용자가 이 DeviceClass를 사용하는 ResourceClaim 또는 ResourceClaimTemplate 을 생성합니다.
- 다양한 조건 기반으로 GPU 자원 할당을 요청합니다.
# 16GiB 이상 메모리를 가진 GPU 요청
apiVersion: resource.k8s.io/v1
kind: ResourceClaim
metadata:
  name: gpu-claim
  namespace: default
spec:
  devices:
    requests:
    - name: gpu
      deviceClassName: nvidia.com/gpu
      selectors:
      - cel:
          expression: device.attributes["memory"].isGreaterThan(quantity("16Gi"))
# 특정 NVLink 메쉬 및 프로필 조건 타겟팅 할당
apiVersion: resource.k8s.io/v1
kind: ResourceClaim
metadata:
name: nvlink-h100-claim
namespace: ai-training
spec:
devices:
requests:
- name: h100-nvlink-pair
deviceClassName: nvidia.com-gpu
allocationMode: ExactCount
count: 2
constraints:
- cel: "device.attributes['gpu.nvidia.com/product-name'] == 'NVIDIA-H100-80GB-HBM3' && device.attributes['gpu.nvidia.com/nvlink-mesh-id'] == 'mesh-0'"# ResourceClaimTemplate 생성
apiVersion: resource.k8s.io/v1
kind: ResourceClaimTemplate
metadata:
name: prod-gpu-template
namespace: ai-serving
spec:
spec:
devices:
requests:
- name: single-gpu-request
deviceClassName: nvidia.com-gpu
allocationMode: ExactCount
count: 1
- Pod에
resourceClaims필드와resources.claim.name을 정의하여 GPU 자원을 사용합니다.
- Deployment나 StatefulSet 아키텍처에서는, ResourceClaimTemplate 을 사용합니다.
apiVersion: v1
kind: Pod
metadata:
  name: gpu-training
  namespace: default
spec:
  resourceClaims:
  - name: gpu
    resourceClaimName: gpu-claim
  containers:
  - name: trainer
    image: nvcr.io/nvidia/pytorch:24.12-py3
    command: ["python", "train.py"]
    resources:
      claims:
      - name: gpu
변화 2: CDI(Container Device Interface) 기본 활성화
[CDI란?]
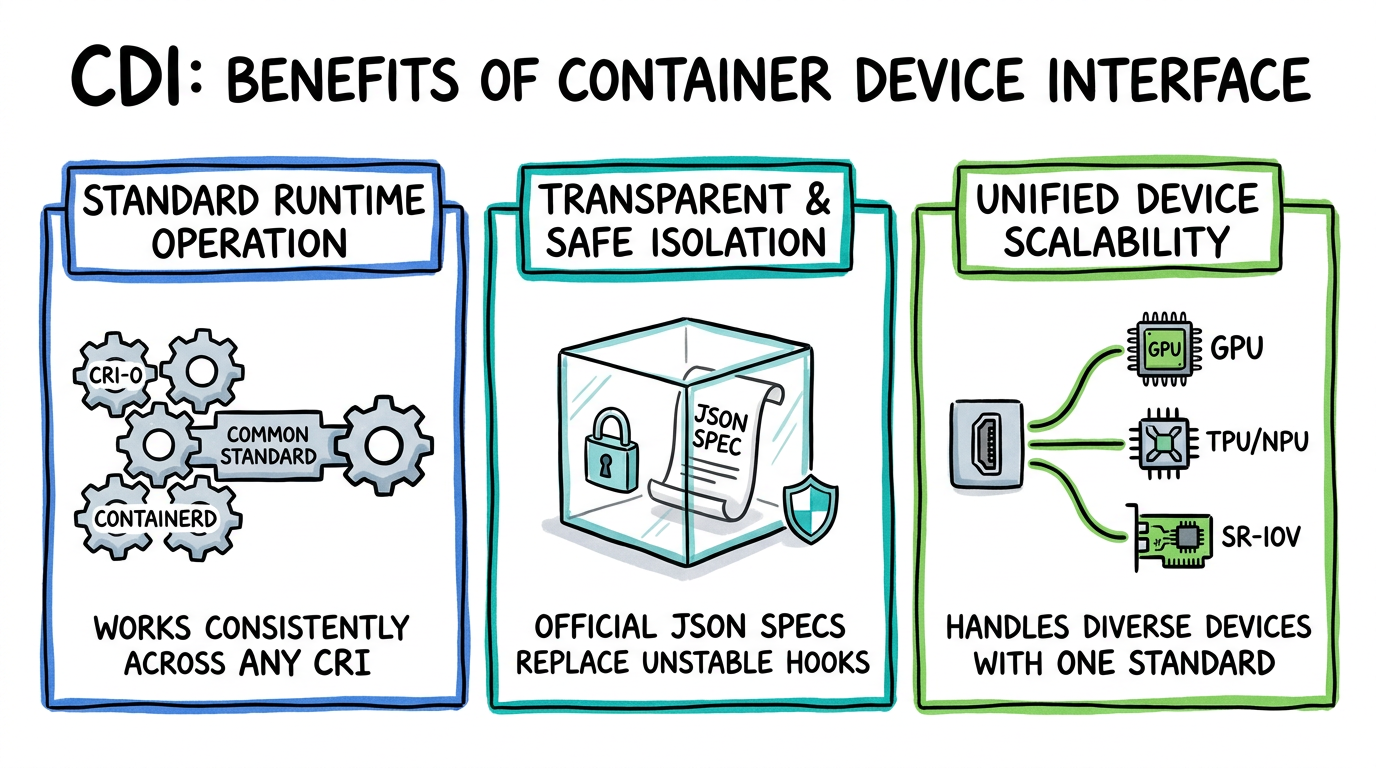
컨테이너 런타임이 GPU 등 특수 장치를 주입하는 디바이스 표준 인터페이스입니다. (마치 네트워크의 CNI, 스토리지의 CSI와 같은 표준 지위를 가집니다.)
runtimeClass 정의 없이 GPU 자원을 컨테이너에 노출할 수 있고, 동일한 규격으로 GPU 뿐만 아니라 NPU, TPU 자원 까지 컨테이너에 주입할 수 있도록 설계되었습니다.
엔비디아 런타임 훅(Runtime Hook)이 컨테이너에 환경 변수를 주입하는 불안정한 방식대신, CDI는 JSON 명세서 기반 표준 구조로 변환하여 안정성을 획득했습니다.
NVIDIA GPU Operator v25.10.0부터 이 CDI가 기본으로 활성화됩니다.
[GPU 자원 할당에 대한 동작 흐름]
- kube-apiserver와 DRA Driver, 그리고 kube-scheduler 가 연동하며, ResourceClaim 으로 정의된 최적의 GPU 자원이 있는 노드에 Pod를 스케줄링합니다.
- 마지막으로 해당 노드의 kubelet 에서 CDI 규격 기반으로 컨테이너에 GPU 자원을 주입합니다.

변화 3: MIG (Multi-Instance GPU) + DRA 통합
[MIG 란?]
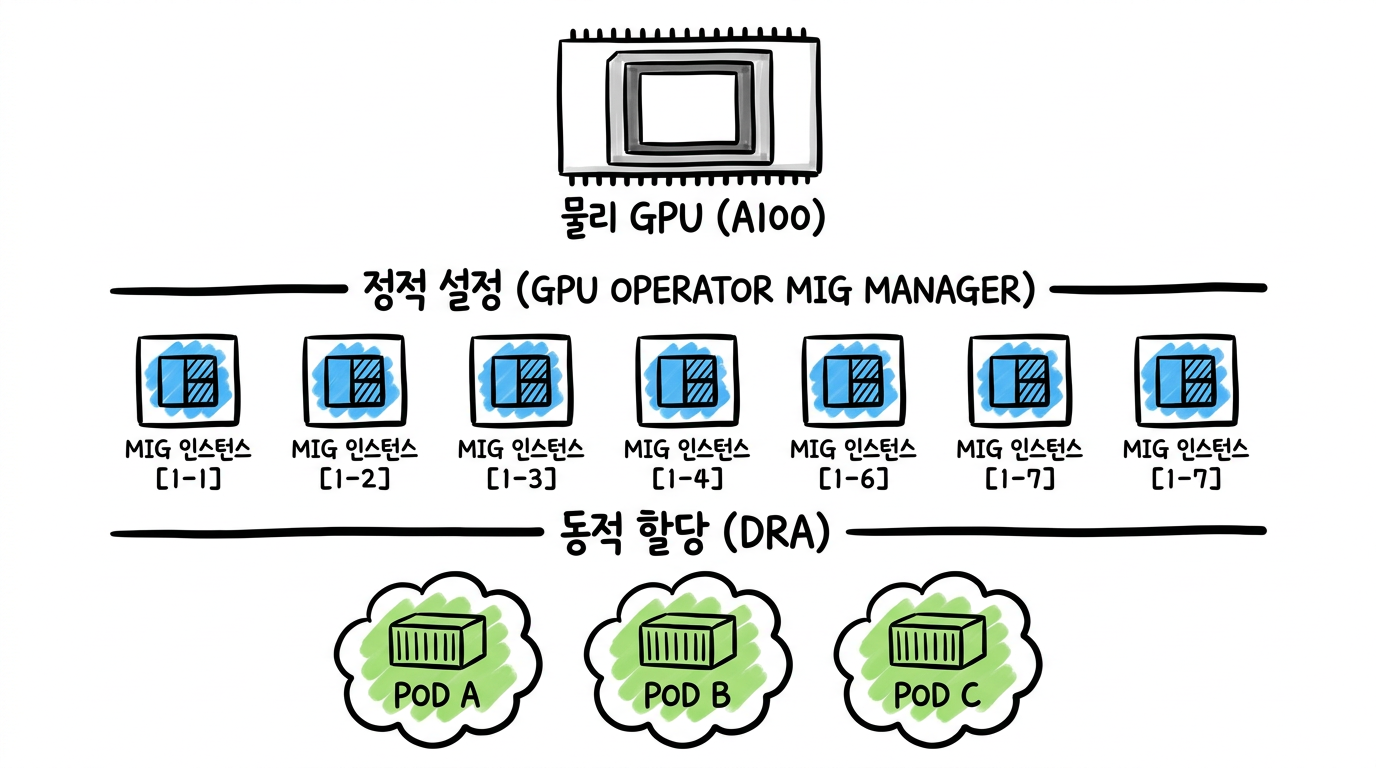
MIG는 NVIDIA A100, H100, H200 등의 GPU를 여러 개의 독립적인 인스턴스로 분할하는 GPU 파티셔닝 기술입니다. 단일 A100/H100을 최대 7개의 격리된 인스턴스로 분할합니다.
DRA와 MIG를 함께 사용하는 경우의 아키텍처는 다음과 같습니다.
[Dynamic MIG Config 자동 생성]
기존에는 클러스터 관리자가 MIG 프로파일을 수동으로 ConfigMap에 정의해야 했습니다.
이제 MIG Manager가 노드의 실제 GPU(예: A100, H100, HGX B300)를 감지하고 지원 가능한 MIG 프로파일 목록을 자동으로 생성합니다.
# MIG Manager가 A100-80GB 노드에 자동 생성
apiVersion: v1
kind: ConfigMap
metadata:
  name: default-mig-parted-config
  namespace: gpu-operator
data:
  config.yaml: |
    version: v1
    mig-configs:
      all-1g.10gb:
        - devices: all
          mig-enabled: true
          mig-devices:
            "1g.10gb": 7
      all-2g.20gb:
        - devices: all
          mig-enabled: true
          mig-devices:
            "2g.20gb": 3
[정리] 기존 방식과의 비교
| 항목 | 기존 방식 (DRA 이전) | DRA/CDI 적용 후 |
| GPU 요청 방식 | nvidia.com/gpu: 1 |
ResourceClaim 기반 속성 요청 |
| 스케줄링 유연성 | 개수만 지정 가능 | 메모리/아키텍처/NVLink 조건 지정 가능 |
| 컨테이너에 GPU 주입 방식 | 환경변수 + 볼륨 마운트 | CDI 스펙 파일 기반 표준화 |
| MIG 설정 | 수동 ConfigMap 정의 필요 | MIG Manager가 자동 생성. 동적 할당 가능. |
| Pod 스펙 | runtimeClassName: nvidia 필수 |
resourceClaims 필드 사용 |
결론
Kubernetes 1.34에서 DRA 메커니즘을 GA로 전환한 것은 GPU 인프라 관리 패러다임의 전환을 의미합니다. 향후 GPU 스케줄링 생태계는 Device Plugin에서 DRA 중심으로 재편될 것입니다.
NVIDIA는 2026년 3월 KubeCon Europe에서 GPU용 DRA 드라이버를 CNCF에 기증하며, 커뮤니티 주도의 오픈소스 생태계로 전환했습니다. 이는 DRA가 특정 벤더 종속성을 벗어나 Kubernetes의 표준 GPU 오케스트레이션 프레임워크로 자리매김할 것임을 시사합니다.
현재 kt cloud의 Managed KS 상품도 GPU 노드 지원을 준비 중에 있습니다. 고객의 서비스가 안정적이고 편리하게 GPU 자원을 Kubernetes 환경에서 활용할 수 있도록 상품 제공에 최선을 다하겠습니다.
자주 묻는 질문 FAQ
관련 / 출처 REFERENCES
'Tech Story > DevOps & Container' 카테고리의 다른 글
| [기술해설] Agentic AI 시대의 Kubernetes 인프라 활용: Agent Sandbox 입문 (0) | 2026.10.08 |
|---|---|
| [플랫폼설계] DevOps에서 Platform Engineering으로: kt cloud의 여정 (0) | 2026.10.02 |
| [활용사례] DevOps 엔지니어가 주목하는 MCP 생태계와 kt cloud PLATFORM 적용기 (0) | 2026.09.23 |
| [구현사례] 신규 프로젝트를 복제 한 번으로 시작하기: 보일러플레이트 템플릿 표준화 (0) | 2026.09.22 |
| [기술사례] 대규모 Kubernetes 환경의 중단 없는 진화를 위한 선택: kt cloud의 Chkk 기반 클러스터 관리 (0) | 2026.08.24 |