
요약 SUMMARY
데이터 전송과 통신 병목을 줄이기 위한 AI 네트워크 설계의 핵심 고려사항을 정리합니다.
#AI네트워크 #분산학습 #RoCEv2 #WAN #JCT
엔터프라이즈 환경에서 클라우드 전환과 AI 도입 프로젝트를 진행할 때 가장 많은 예산과 논의가 집중되는 영역은 단연 컴퓨팅 인프라입니다. 고성능 GPU의 확보 수량이나 GPU 클러스터의 전체 연산 능력(TFLOPS) 등이 주로 핵심 평가지표로 다루어집니다.
그러나 시스템 아키텍처를 설계하고 클라우드 랜딩존(Landing Zone)을 구성하는 엔지니어 관점에서 볼 때, 실제 병목과 인프라 측면의 과제는 GPU 서버의 가동 이후 본격적인 데이터 파이프라인을 구동하는 시점부터 시작됩니다. 아무리 연산 성능이 뛰어난 GPU 클러스터를 구축했더라도, 데이터가 이동하는 경로인 네트워크 인프라의 대역폭과 신뢰성이 뒷받침되지 못하면 하드웨어 자원의 잠재력을 온전히 활용할 수 없기 때문입니다.
Cisco의 최신 'AI Network Traffic Report' 분석에 따르면, AI 워크로드는 단순히 처리하는 트래픽의 총량을 증가시키는 것에 그치지 않고 트래픽이 가진 구조적 성질 자체를 근본적으로 변화시키고 있습니다.
1. AI는 왜 기존 네트워크 상식을 깨는가
전통적인 클라우드 환경의 네트워크 설계는 '통계적 다중화(Statistical Multiplexing)' 원칙을 기반으로 발전해 왔습니다. 웹 서비스, API 호출, 데이터베이스 쿼리 등은 수많은 사용자가 각기 다른 시간에 비교적 작은 크기의 데이터를 주고받는 형태입니다. 이러한 트래픽은 상호 간섭이 적고, 패킷 유실이 발생하더라도 TCP 혼잡 제어 알고리즘을 통해 자연스럽게 재전송 및 복구가 가능하므로 사용자 경험에 미치는 영향이 제한적입니다.
반면, AI 인프라가 유발하는 트래픽은 대규모 학습 단계와 실시간 추론 단계 전반에서 기존의 네트워크 설계 기준을 상회하는 요구사항을 가집니다.
A. 데이터 인제스트 및 분산 학습 단계 — 대역폭 포화와 무손실 환경 요구 AI 모델 학습을 위해 수십에서 수백 테라바이트(TB)에 이르는 데이터셋을 스토리지에서 GPU 클러스터로 전송하는 단계는 전형적인 대용량 지속 트래픽(Bulk Transfer)의 형태를 띱니다. 기존 엔터프라이즈 환경에서 주로 사용되는 10G 또는 40G 대역폭의 전용 회선은 이 트래픽이 진입하는 순간 즉시 포화 상태에 도달하게 되며, 동일한 대역폭을 공유하는 일반 비즈니스 시스템의 대기 시간을 급격히 증가시키는 요인이 됩니다.
더욱 엄격한 관리가 필요한 영역은 분산 학습 단계입니다. 수백 대의 GPU 노드가 연산 결과인 가중치(Weight)를 실시간으로 교환하고 동기화(All-Reduce 통신)하는 내부망 트래픽은 미세한 패킷 손실도 허용하지 않는 구조를 가집니다. 패킷 드롭이 단 하나만 발생하더라도 나머지 전체 GPU 노드가 해당 데이터가 재전송되어 도달할 때까지 연산을 멈추고 대기하는 '낙오자 현상(Straggler Problem)'이 발생하기 때문입니다. 막대한 비용이 소요되는 GPU 자원의 공회전을 방지하기 위해, 분산 학습 환경에서는 RoCEv2(RDMA over Converged Ethernet) 프로토콜에 PFC(Priority-based Flow Control) 및 ECN(Explicit Congestion Notification)을 조합한 무손실 이더넷 패브릭이나 인피니밴드(InfiniBand) 기반의 전용 네트워크 아키텍처가 필수적으로 요구됩니다.
B. 추론(Inference) 단계 — 장기 지속 흐름과 비대칭적 트래픽 구조 사용자의 요청에 응답하는 추론 단계의 트래픽은 학습 단계와는 또 다른 기술적 과제를 제시합니다. Cisco 보고서에 따르면, AI 추론 트래픽은 토큰을 순차적으로 생성하여 출력하는 연산 특성으로 인해 일반적인 웹 트래픽에 비해 초당 전송률은 낮은 반면, 세션이 유지되는 '흐름 지속 시간(Flow Duration)'이 약 2배 이상 길어지는 장기 지속 흐름(Long-lived Flow)의 형태를 보입니다.
트래픽의 총량보다 세션을 장시간 유지해야 한다는 점이 네트워크 장비에 부담을 주게 됩니다. 연결 상태와 세션을 실시간으로 추적·관리해야 하는 방화벽이나 침입 탐지 시스템(IDS) 등 보안 장비의 플로우 테이블(Flow Table)이 지속적으로 누적되어 임계치를 초과하는 병목 현상이 발생할 수 있습니다.
이에 더해, 컨텍스트 정보가 포함된 프롬프트의 입력으로 인해 업스트림(Upstream) 트래픽의 비중이 일반적인 웹 환경(약 0.5%) 대비 현저히 높은 약 9% 수준에 달한다는 점, RAG(검색 증강 생성) 아키텍처 적용 시 벡터 데이터베이스의 실시간 조회 트래픽과 토큰 스트리밍 응답이 교차하며 발생하는 지터(Jitter) 통제 문제 역시 기존 웹 서비스 중심의 설계 기준으로는 대응하기 까다로운 변수입니다.
2. WAN(광역망) 아키텍처의 재편과 데이터 중력(Data Gravity)의 영향
AI 트래픽의 파급 효과는 단일 데이터센터 내부의 네트워크 환경을 넘어, 여러 거점을 연결하는 WAN(Wide Area Network) 아키텍처의 변혁을 이끌어내고 있습니다.
과거의 클라우드 아키텍처는 중앙의 퍼블릭 클라우드 리전에 컴퓨팅 자원과 스토리지를 집중시키고 지사나 온프레미스 환경에서 광역망을 통해 접근하는 허브 앤 스포크(Hub-and-Spoke) 구조가 일반적이었습니다. 그러나 AI 인프라 운영 환경에서는 데이터의 규모가 커질수록 이동 비용과 제약이 커지는 '데이터 중력(Data Gravity)' 법칙의 영향을 강하게 받습니다. 유전체 분석 데이터, 자율주행 차량의 로그 데이터, 고해상도 제조 공정 이미지 등 페타바이트(PB) 단위의 물리적 원천 데이터를 특정 클라우드 센터로 일괄 전송하는 것은 물리적 시간과 비용 측면에서 비효율적입니다.
결과적으로 "데이터를 연산 자원이 있는 곳으로 이동시킬 것인가, 연산 자원을 데이터가 위치한 곳으로 가져갈 것인가"라는 질문 직후 WAN은 두 가지 방향으로 진화하고 있습니다.
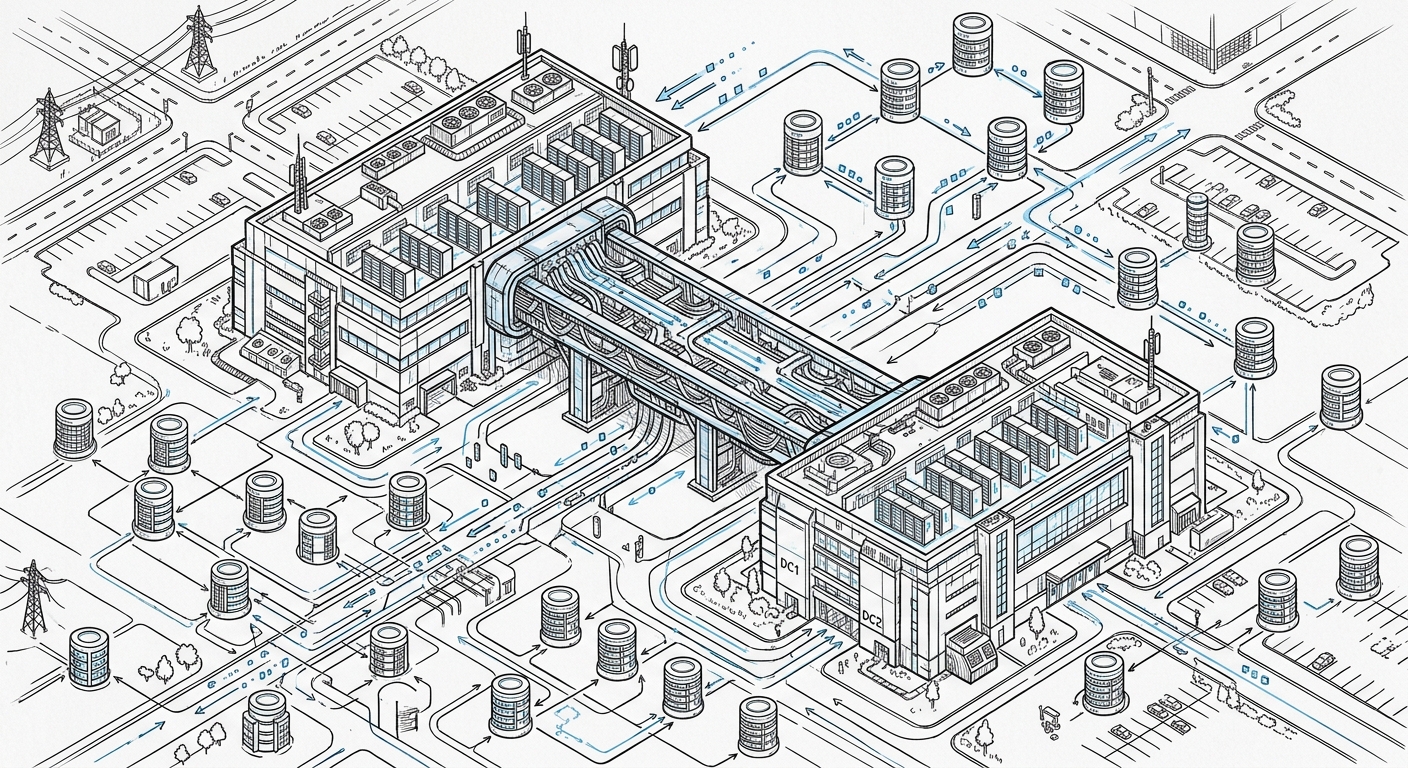
첫 번째는 지리적으로 분산된 다수의 데이터센터에 존재하는 GPU 자원을 하나의 논리적 클러스터로 연결하는 초광대역 DCI(Data Center Interconnect)의 도입입니다. 데이터센터 간 유기적인 연산을 위해 400G 및 800G를 넘어 테라비트(Tbps)급 광통신 백본망을 구성하고, 전송 구간의 보안을 위한 MACsec 기반의 가속 암호화를 적용함에 따라 WAN 경계 라우팅 장비의 하드웨어 처리 스펙 요구사항이 크게 강화되고 있습니다.
두 번째는 하이브리드 인프라 기반의 에지 추론(Edge Inference) 환경 구축입니다. AI 모델의 학습은 대규모 코어 데이터센터에서 수행하되, 실제 실시간 추론 연산은 데이터가 발생하는 공장, 지사, 온프레미스 에지 인프라에서 즉각 처리하는 분산 구조입니다. 이 환경에서 WAN은 단순한 데이터 전송 통로를 넘어, 업데이트된 대용량의 모델 가중치(Weight) 파일을 수만 개의 분산 에지 노드로 지연 없이 동기화하고 관리하는 지능형 라우팅 프로토콜 아키텍처로 고도화되고 있습니다.
3. JCT(Job Completion Time): AI 인프라 성능 평가의 핵심 지표
네트워크 트래픽 패러다임의 변화는 인프라의 효율성을 검증하고 평가하는 기준의 전환을 요구합니다. 과거 엔터프라이즈 인프라 환경에서는 단순한 '가용 대역폭'이나 '평균 응답 속도'가 중심 지표였으나, 대규모 AI 인프라 운영에서는 JCT(Job Completion Time, 작업 완료 시간)가 가장 결정적인 관리 지표로 다루어집니다.
연산 능력이 뛰어난 최고 사양의 하드웨어를 배치하더라도, 네트워크 패킷 드롭이나 버퍼 오버플로우로 인해 데이터의 입출력(I/O) 대기 시간이 장기화되면 최종 JCT는 기하급수적으로 증가하게 됩니다. 고비용의 GPU 클러스터가 연산을 수행하지 못하고 데이터를 기다리며 공회전하는 시간은 고스란히 기업의 재무적 손실과 직결됩니다.
따라서 클라우드 및 인프라 아키텍트는 네트워크를 물리적으로 '연결'하는 관점에서 한 걸음 더 나아가, 전체 컴퓨팅·스토리지·네트워크 간의 자원 병목 구간을 종합적으로 식별하고 분산 통신 효율을 최적화하여 최종 JCT를 최소화하는 방향으로 거버넌스를 확립해야 합니다.
마치며

AI 기술의 도입과 모델의 거대화 이면에는, 방대한 양의 데이터 흐름을 지연과 오차 없이 실시간으로 수용해야 하는 묵직한 네트워크 인프라의 과제가 존재합니다. 화려한 연산 장치의 스펙 경쟁 못지않게, 그 연산 자원이 유발하는 독특한 트래픽 패턴을 기존 사내 인프라 환경 내에서 안전하게 격리하고 제어할 수 있는 가드레일을 설계하는 것이 중요합니다. 눈에 보이지 않는 패킷 흐름의 구조적 안정성을 확보하는 것이야말로 향후 성공적인 AI 트랜스포메이션을 완성하는 핵심 열쇠가 될 것입니다.
자주 묻는 질문 FAQ
관련 / 출처 REFERENCES
'Tech Story > Tech Inside' 카테고리의 다른 글
| [인사이트] 로봇은 왜 챗봇과 GPU 수요가 다를까? 피지컬 AI 시대의 인프라 전략 (0) | 2026.10.21 |
|---|---|
| [분석] DDoS 환경에서 OVS kernel datapath 성능 붕괴 (0) | 2026.10.14 |
| [인사이트] GPUaaS 네트워크 경쟁 구조 분석 (0) | 2026.10.08 |
| [기술분석] AI 추론 메모리 병목과 서버 아키텍처 변화 (1) | 2026.09.23 |
| [kt cloud] kt cloud PLATFORM IAM, 계정 관리를 넘어 정교한 보안 거버넌스로 (0) | 2026.08.24 |