
요약 SUMMARY
NVLink, InfiniBand, RoCE, 고속 Ethernet의 역할을 다룹니다.
대규모 GPU 클러스터에서 데이터 교환 병목을 줄이기 위한 연결 구조의 중요성을 정리합니다.
#GPUaaS #NVLink #InfiniBand #RoCE #GPU클러스터
생성형 AI가 본격적으로 확산되면서 클라우드 인프라를 바라보는 기준도 빠르게 바뀌고 있습니다. 예전에는 CPU 기반 가상 서버를 얼마나 안정적으로 제공하느냐가 중요했다면, 지금은 대규모 AI 모델을 얼마나 빠르게 학습시키고 안정적으로 운영할 수 있느냐가 더 중요한 기준이 됐습니다. NVIDIA는 AI 인프라를 설명할 때 NVLink 기반 scale-up과 InfiniBand·Ethernet 기반 scale-out을 포함한 전체 네트워킹 패브릭을 함께 제시하고 있고, kt cloud도 GPU 기반 AI 학습·AI 추론·고성능 컴퓨팅용 인프라를 중심으로 서비스를 전개하고 있습니다.
GPUaaS는 GPU 자원을 클라우드 형태로 제공하여 AI 학습과 추론을 수행할 수 있도록 하는 서비스 모델입니다.
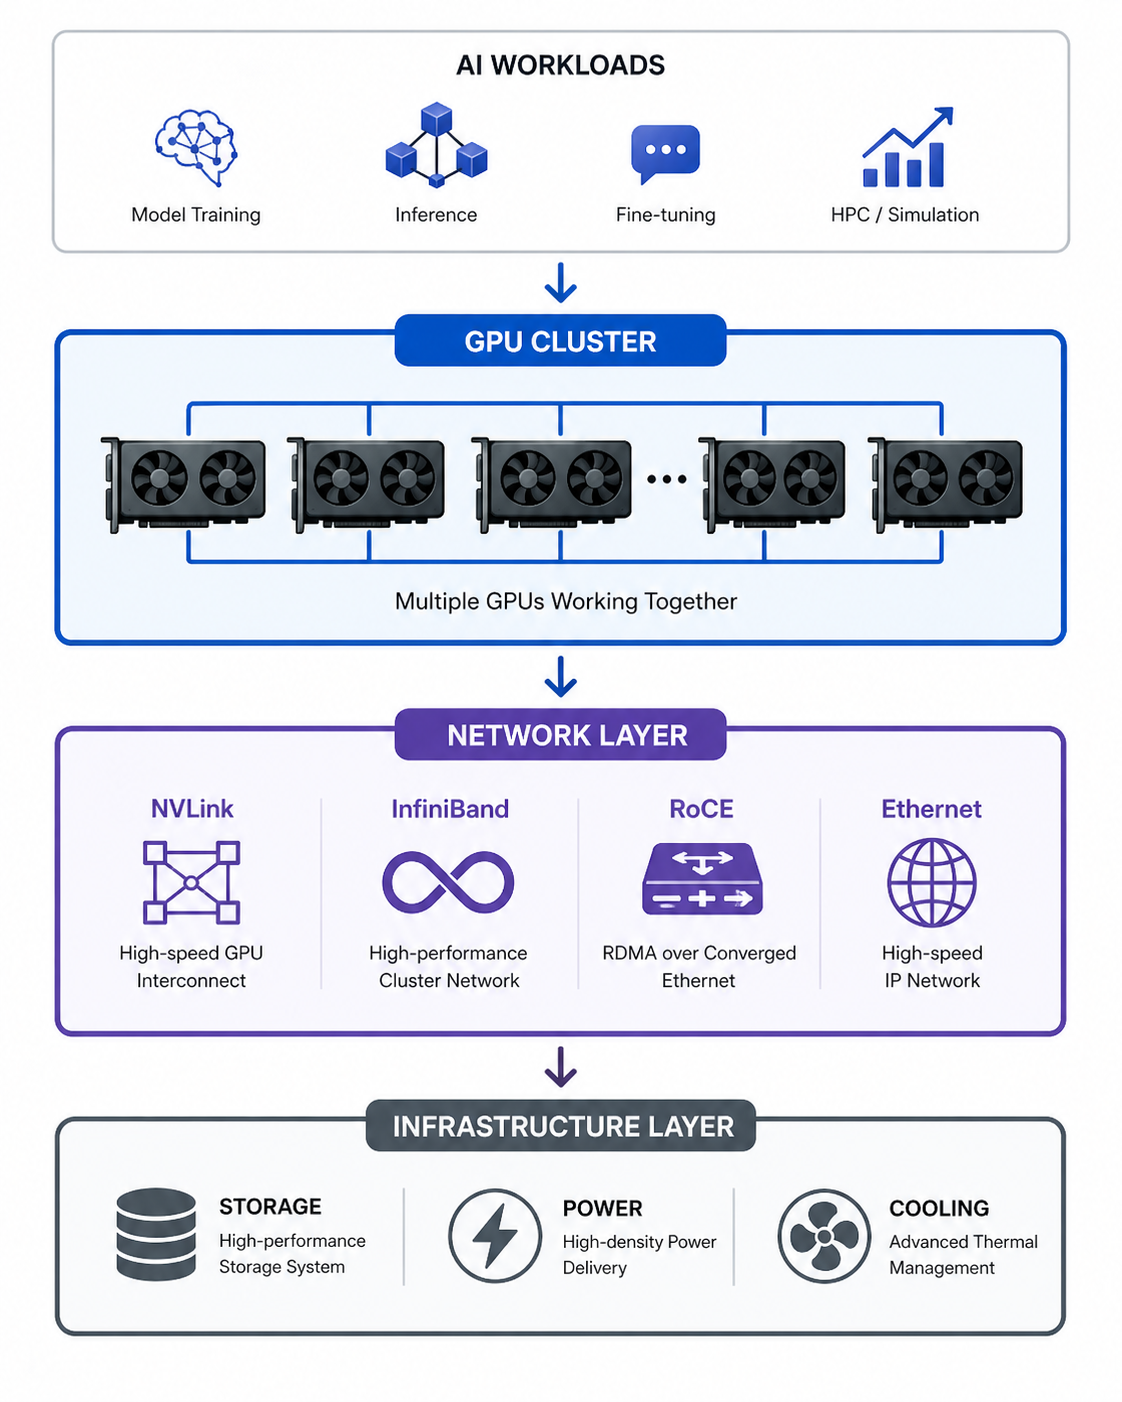
국내 시장에서도 이 흐름은 더 이상 먼 이야기가 아닙니다. GPUaaS는 단순히 비싼 GPU를 빌려주는 서비스가 아니라, AI 워크로드를 실제로 감당할 수 있는 데이터센터 역량 전체를 보여주는 영역으로 바뀌고 있습니다. 이 점에서 GPU 서버, 스토리지, 전력, 냉각, 네트워크는 따로 존재하는 요소가 아니라 하나의 시스템처럼 함께 설계돼야 합니다. NVIDIA가 AI 팩토리 관점에서 NVLink, InfiniBand, Ethernet, DPU까지 하나의 스택으로 제시하는 것도 같은 이유입니다.
왜 GPUaaS가 빠르게 중요해졌나?
이유는 단순합니다. 최신 AI 워크로드는 더 이상 한 대의 서버 안에서 끝나지 않기 때문입니다. 대형 언어모델과 멀티모달 모델은 수십 개에서 수백 개, 많게는 수천 개의 GPU가 동시에 연결된 환경을 전제로 학습됩니다. 이 과정에서 GPU는 연산을 맡고, 스토리지는 데이터를 공급하며, 네트워크는 계산 결과와 파라미터를 빠르게 주고받게 만듭니다. 어느 한 축이라도 받쳐주지 못하면 전체 학습 시간은 길어지고 운영 효율도 급격히 떨어집니다. 그래서 오늘날 GPUaaS의 핵심은 GPU를 많이 확보하는 것만이 아니라, 그 GPU를 얼마나 잘 연결하고 안정적으로 운영할 수 있는가에 있습니다.
GPUaaS는 무엇을 함께 제공하나?
겉으로 보면 GPUaaS는 GPU 서버를 임대하는 서비스처럼 보입니다. 하지만 실제 경쟁력은 그보다 훨씬 넓은 범위에서 결정됩니다. 먼저 GPU 컴퓨팅 계층이 있어야 하고, 그 위에 데이터를 제때 공급할 수 있는 스토리지 구조가 필요합니다. 여기에 전력과 냉각 설계가 받쳐줘야 고밀도 GPU 환경을 안정적으로 운영할 수 있습니다. 그리고 이 모든 요소를 실제 성능으로 묶어 주는 계층이 바로 네트워크입니다. kt cloud가 GPU 기반 AI 인프라를 통해 학습·추론·HPC 워크로드를 지원하는 구조를 제시하는 점도, GPUaaS가 단순 장비 제공이 아니라 워크로드 운영 기반이라는 점을 보여줍니다.
초고속 네트워크가 왜 최근 더 중요해졌나?
GPUaaS를 이야기할 때 많은 사람이 먼저 GPU 종류나 개수에 주목합니다. 물론 중요합니다. 하지만 실제 AI 학습 성능을 결정하는 것은 GPU만이 아닙니다. 여러 GPU가 동시에 일하는 환경에서는, 계산한 결과를 얼마나 빠르게 주고받을 수 있는지가 전체 속도를 크게 좌우합니다. 그래서 최근에는 GPU 성능만큼이나 네트워크 구조가 중요해졌습니다. Google Cloud는 AI 워크로드에 RoCE v2 기반 RDMA 네트워크를 제공하며, 이런 환경에서는 높은 대역폭과 낮은 지연이 핵심이라고 설명합니다.
이유는 생각보다 단순합니다. 대규모 AI 학습은 여러 GPU가 각자 맡은 계산을 수행한 뒤, 그 결과를 계속 서로 맞춰 가는 방식으로 진행됩니다. 이때 대표적으로 사용되는 방식이 AllReduce라는 집단 통신입니다. 쉽게 말해 각 GPU가 계산한 결과를 한 번에 모아 다시 전체 GPU에 빠르게 공유하는 과정입니다. 문제는 이 작업이 학습 과정 내내 반복된다는 점입니다. GPU 성능이 높아질수록 오히려 이 데이터 교환 과정이 병목이 되기 쉬워지고, 결국 네트워크 성능이 전체 학습 속도를 좌우하게 됩니다. 이 설명이 중요한 이유는, 왜 GPUaaS에서 네트워크가 선택사항이 아니라 핵심 경쟁력인지 가장 직관적으로 보여주기 때문입니다.
이 구조 때문에 AI 학습에서는 연산 성능보다 데이터 교환 속도가 전체 성능을 결정하는 경우가 많습니다.
즉, GPUaaS에서는 GPU가 많다고 해서 성능이 자동으로 좋아지는 것이 아닙니다. GPU가 아무리 빨라도, 서로 연결된 속도가 충분히 빠르지 않으면 계산이 끝난 뒤 대기 시간이 길어집니다. 결국 비싼 GPU를 많이 확보해도 네트워크가 받쳐주지 못하면 기대한 성능을 내기 어렵습니다. 그래서 최근 AI 데이터센터에서는 GPU 자체보다 GPU를 어떻게 연결하느냐가 더 중요한 설계 요소로 떠오르고 있습니다. NVIDIA 역시 AI 인프라를 설명할 때 네트워크를 독립된 핵심 계층으로 다룹니다.
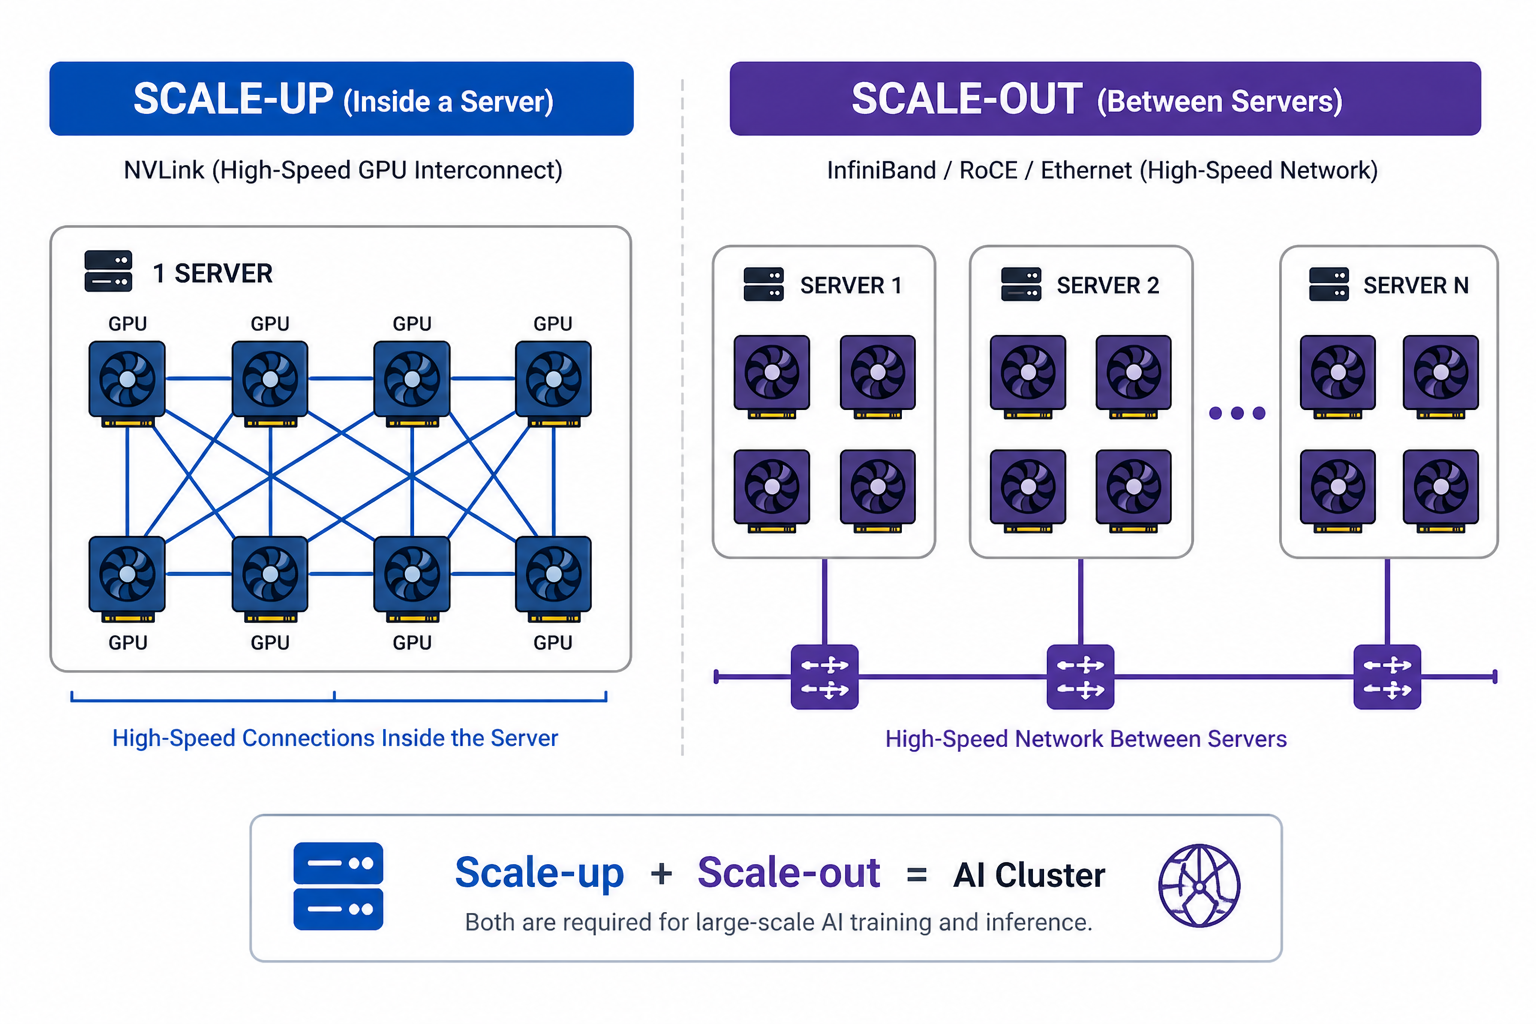
여기서 한 가지 더 중요한 점이 있습니다. AI 인프라의 연결 구조는 한 종류로만 이뤄지지 않습니다. 쉽게 말해 서버 안에서 GPU끼리 연결하는 방식과 서버 밖에서 여러 서버를 연결하는 방식이 서로 다릅니다. 이 두 구조가 함께 잘 맞물려야 대규모 AI 학습이 효율적으로 돌아갑니다. NVIDIA는 이 구조를 NVLink scale-up과 InfiniBand·Ethernet scale-out으로 구분해 설명합니다.
NVLink는 어떤 역할을 하나?
먼저 서버 안쪽을 보면, 여러 GPU가 매우 빠르게 연결되어야 합니다. 이 역할을 하는 대표 기술이 NVLink입니다. NVLink는 한 서버 안이나 가까운 범위에서 GPU끼리 데이터를 빠르게 주고받도록 돕는 연결 기술입니다. 쉽게 이해하면, 여러 GPU가 따로 놀지 않고 훨씬 더 빠르게 협업할 수 있도록 만드는 내부 고속도로에 가깝습니다. NVIDIA는 NVLink와 NVSwitch 조합이 AI 성능을 효율적으로 확장하게 만든다고 설명합니다.
다만 NVLink가 여러 GPU를 완전히 하나의 GPU로 만드는 것은 아닙니다. 실제 학습과 병렬 처리는 여전히 소프트웨어와 프레임워크가 제어합니다. 그럼에도 NVLink가 중요한 이유는 GPU끼리 데이터를 주고받는 속도를 크게 높여, 대규모 연산을 훨씬 효율적으로 처리하게 만들기 때문입니다. 그래서 NVLink는 AI 인프라에서 서버 내부 성능을 높이는 핵심 연결 기술로 자주 언급됩니다. NVIDIA는 GB200 NVL72를 소개하면서 72개 GPU를 하나의 NVLink 도메인으로 연결하는 구조를 강조합니다.
서버 밖 연결은 왜 또 따로 중요한가?
AI 학습이 커질수록 한 서버 안의 GPU만으로는 부족합니다. 결국 여러 서버를 묶어 더 큰 클러스터를 만들어야 합니다. 이때 필요한 것이 서버와 서버를 연결하는 외부 네트워크입니다. 대표적으로 InfiniBand, RoCE, 고속 Ethernet이 이 영역에서 많이 언급됩니다. 세 기술의 목적은 모두 같습니다. 여러 서버에 분산된 GPU들이 빠르게 데이터를 주고받도록 만드는 것입니다.
InfiniBand는 오래전부터 고성능 컴퓨팅과 AI 환경에서 많이 쓰인 전용 고속 네트워크입니다. 지연이 낮고 대규모 통신에 강하다는 점이 장점입니다. NVIDIA는 Quantum InfiniBand를 AI 네트워킹의 핵심 축 중 하나로 제시하고 있고, DGX 시스템 문서에서도 클러스터 카드가 최대 400Gbps InfiniBand를 지원한다고 안내합니다.
RoCE는 Ethernet 기반 환경에서 고성능 통신을 구현하는 방식입니다. 쉽게 말해, 기존 데이터센터에서 널리 쓰이던 Ethernet 구조를 유지하면서도 AI 학습에 필요한 빠른 데이터 전송 성능을 확보하려는 접근입니다. Google Cloud는 2025년 공식 블로그와 2026년 RDMA 네트워크 프로필 문서에서 RoCE v2와 RDMA 네트워크를 AI 워크로드용으로 소개하고 있습니다.
고속 Ethernet은 가장 익숙한 네트워크 계열이지만, 최근에는 AI 데이터센터에 맞게 훨씬 더 빠르고 정교하게 발전하고 있습니다. NVIDIA ConnectX Ethernet NIC는 최대 400Gb/s를 지원하고, Spectrum-X는 일반적인 Ethernet 대비 AI 네트워크 성능 향상을 전면에 내세우고 있습니다. 예전의 Ethernet이 범용 데이터센터 네트워크의 기본 기술이었다면, 지금은 AI 전용 최적화가 강화된 중요한 선택지로 자리 잡고 있습니다.
결국 무엇이 중요한가?
정리하면 구조는 생각보다 간단합니다. 서버 안에서는 NVLink가 GPU끼리 빠르게 연결되고, 서버 밖에서는 InfiniBand·RoCE·고속 Ethernet이 여러 서버를 연결합니다. 즉, AI 데이터센터는 하나의 네트워크만 잘 만들면 되는 것이 아니라, 내부 연결과 외부 연결이 함께 최적화돼야 제대로 성능이 나오는 구조입니다. NVIDIA가 AI 인프라를 풀스택 패브릭으로 설명하는 이유도 여기에 있습니다.
그래서 최근 GPUaaS 경쟁은 단순히 GPU를 얼마나 많이 확보했느냐가 아니라, 그 GPU들을 얼마나 빠르고 안정적으로 연결해 실제 AI 학습 성능으로 이어지게 만들 수 있느냐의 경쟁으로 바뀌고 있습니다. 이 점에서 네트워크는 더 이상 보조 요소가 아니라, GPUaaS의 완성도를 결정하는 핵심 인프라라고 볼 수 있습니다.
국내 시장에서 이 흐름은 어떻게 봐야 하나?
국내 중심으로 보면 지금은 중요한 전환점입니다. 아직 글로벌 하이퍼스케일 사업자 수준의 규모를 그대로 따라가기는 어렵지만, 국내 사업자들도 분명히 AI 특화 인프라 역량을 빠르게 갖추고 있습니다. kt cloud는 GPU 기반 AI 워크로드를 중심으로 클라우드 인프라를 확장하고 있으며, AI 데이터센터와 연계된 인프라 전략을 지속적으로 강화하고 있습니다.
이런 관점에서 앞으로 더 중요한 질문은 GPU가 몇 장인가가 아닙니다. 얼마나 큰 GPU 클러스터를 안정적으로 돌릴 수 있는가, 내부 연결과 외부 네트워크를 얼마나 정교하게 설계했는가, 고객이 실제 AI 워크로드를 올렸을 때 성능과 운영 경험을 얼마나 일관되게 보장할 수 있는가가 더 중요해집니다. 결국 GPUaaS의 경쟁력은 장비 수량보다 연결 구조와 운영 완성도에서 갈릴 가능성이 큽니다.
마무리하며
GPUaaS는 더 이상 고가 GPU를 빌려주는 서비스에 머물지 않습니다. 지금의 GPUaaS는 AI 시대의 인프라 플랫폼입니다. 그리고 그 경쟁은 단순한 GPU 개수 경쟁이 아니라, GPU를 중심으로 전력, 냉각, 스토리지, 네트워크, 운영 체계를 얼마나 유기적으로 엮을 수 있는가의 경쟁으로 바뀌고 있습니다. 특히 네트워크는 이제 성능을 보조하는 요소가 아니라, AI 인프라의 실제 효율을 결정하는 핵심 변수로 올라섰습니다. 여러 GPU가 계산한 결과를 끊임없이 주고받는 환경에서는 연결 구조가 곧 성능이기 때문입니다.
국내 시장에서도 이 흐름은 이미 시작됐습니다. 앞으로 GPUaaS의 승부는 누가 더 많은 GPU를 보유했는가보다, 누가 더 잘 연결하고 더 안정적으로 운영하며 더 현실적인 AI 인프라 경험을 제공하느냐에서 갈릴 것입니다. 그리고 그 차이를 가장 선명하게 보여주는 요소가 바로 네트워크입니다.
결국 GPUaaS 환경에서는 GPU 성능이 아니라, 연결 구조가 실제 성능을 완성합니다.
자주 묻는 질문 FAQ
관련 / 출처 REFERENCES
- kt cloud, 「GPU Server 상품 개요」 kt cloud Cloud manual.
- kt cloud, 「Hyperscale AI Computing 모델 구성」 kt cloud 내부 자료.
- NVIDIA, 「Overview of NCCL」 NVIDIA NCCL Documentation.
- NVIDIA, 「Collective Operations」 NVIDIA NCCL Documentation.
- NVIDIA, 「Networking」 NVIDIA DGX GB Rack Scale Systems User Guide.
- NVIDIA, 「NVIDIA HGX Platform」 NVIDIA 공식 사이트.
- Google Cloud, 「RDMA RoCEv2 for AI workloads on Google Cloud」 Google Cloud Blog, 2025.
'Tech Story > Tech Inside' 카테고리의 다른 글
| [기술분석] AI 추론 메모리 병목과 서버 아키텍처 변화 (1) | 2026.09.23 |
|---|---|
| [kt cloud] kt cloud PLATFORM IAM, 계정 관리를 넘어 정교한 보안 거버넌스로 (0) | 2026.08.24 |
| [기술동향] LLM 추론 최적화 핵심 기술: 양자화, KV 캐시, 추론 칩 (0) | 2026.08.06 |
| [kt cloud] kt cloud PLATFORM, 공공 클라우드를 위한 차세대 운영 기반 (0) | 2026.07.24 |
| [Tech Series] kt cloud AI 검색 증강 생성(RAG) #5 : 검색 고도화(Retrieval Optimization)와 리랭킹(Re-ranking) 기술 (0) | 2026.06.05 |