
요약 SUMMARY
GPU 자원 최적화, 분산 학습의 성능과 장애 복원력, AI 기반 운영 자동화 및 주요 전시 기술을 다룹니다.
AI 인프라의 경쟁력이 하드웨어 확보뿐 아니라 자원 활용 효율과 안정적인 운영에 달려 있다는 현장 시사점을 정리합니다.
#KubeConChina2026 #AI인프라 #GPU자원관리 #분산학습 #운영자동화
안녕하세요! kt cloud 마케팅커뮤니케이션팀 입니다. 🙋♂️
AI 인프라 하면 가장 먼저 무엇이 떠오르시나요? 아마 많은 분이 GPU를 생각하실 텐데요. 더 많은 GPU와 더 빠른 네트워크를 확보하기 위한 경쟁이 치열해지면서 AI 인프라의 규모도 빠르게 커지고 있죠.
그런데 아무리 뛰어난 GPU를 갖췄더라도 제대로 활용하지 못한다면 어떨까요? 어떤 GPU는 사용되지 않은 채 대기하고, 다른 GPU는 자원이 부족해 작업을 시작하지 못할 수도 있어요. 심지어 일부 장비의 장애로 오랫동안 진행한 AI 학습이 중단되는 상황도 발생할 수 있죠.
AI가 연구·개발을 넘어 실제 서비스로 확산되면서 이제는 얼마나 뛰어난 하드웨어를 확보했는가 못지않게, 확보한 자원을 얼마나 효율적이고 안정적으로 운영할 수 있는가가 중요한 과제로 떠오르고 있습니다.
이러한 기술의 변화를 직접 살펴보기 위해 kt cloud의 네트워크·클라우드·데이터 플랫폼·통합관제 분야 임직원들이 중국 상하이로 향했습니다. 바로 KubeCon + CloudNativeCon + OpenInfra Summit + PyTorch Conference China 2026에 참석하기 위해서였는데요!
이번 현장 스케치에서는 참관단이 인상 깊게 들었던 네 가지 기술 세션부터 전시장에서 눈여겨본 AI 인프라 장비와 솔루션까지, 상하이에서 만난 이야기를 여러분과 함께 나눠보려고 해요.
과연 상하이 현장에서는 어떤 기술들이 주목받고 있었을까요? 함께 살펴보시죠! 🔍
클라우드 네이티브와 AI가 만난 상하이
지난 9월, 중국 상하이의 Shanghai International Convention Center에는 클라우드 네이티브와 오픈 인프라, AI 분야의 기술 전문가들이 한자리에 모였습니다.
Cloud Native Computing Foundation(CNCF), OpenInfra Foundation, PyTorch Foundation이 함께한 대규모 기술 컨퍼런스가 열렸기 때문인데요.
Kubernetes, OpenStack, PyTorch 등 주요 오픈소스 기술을 중심으로 다양한 발표와 전시가 진행되면서 AI 시대의 인프라가 어떤 방향으로 발전하고 있는지 살펴볼 수 있는 자리였어요.

📍 KubeCon China 2026 한눈에 보기
- 공식 행사명: KubeCon + CloudNativeCon + OpenInfra Summit + PyTorch Conference China 2026
- 일정: 2026년 9월 7~9일
- 장소: 중국 상하이, Shanghai International Convention Center
- 주요 분야: 클라우드 네이티브, 오픈 인프라, AI 프레임워크, GPU·NPU, 분산 학습, 보안, 관측성, 운영 자동화
이번 행사에서 특히 흥미로웠던 건 익숙한 클라우드 기술들이 AI 인프라를 운영하는 데에도 중요한 역할을 하고 있다는 점이었어요.

기존에 서버와 애플리케이션을 관리하는 데 주로 활용되던 Kubernetes와 OpenStack이 이제는 대규모 GPU 자원을 관리하고, AI 학습과 추론 서비스를 뒷받침하는 기술로도 활용되고 있었거든요.
발표 주제도 상당히 구체적이었습니다. GPU를 어떻게 하면 더 효율적으로 나눠 사용할 수 있을지, 대규모 AI 학습 중 장애가 발생하면 어떻게 대응할지, 나아가 AI가 직접 운영 과정의 문제를 분석하고 해결을 도울 수 있을지까지!
실제 AI 인프라를 운영하는 과정에서 마주할 법한 고민들이 다양한 기술 사례로 소개되고 있었죠.
인상 깊었던 세션 — AI를 잘 운영하기 위한 이야기
이번 행사에서는 글로벌 기업들이 AI 인프라를 구축하고 운영하면서 얻은 경험과 기술적 노하우를 공유했는데요.
그중에서도 Viettel, Huawei, Meta, IBM·Red Hat의 발표가 눈길을 끌었습니다.
기업마다 풀고자 하는 문제는 달랐지만, 모두 AI 인프라의 운영 효율성과 안정성을 높이기 위한 고민에서 출발했다는 공통점이 있었어요.
1. GPU를 더 효율적으로 사용하는 방법 — Viettel의 Token-as-a-Service
먼저 소개할 발표는 베트남의 대형 통신사업자 Viettel의 이야기입니다.
Viettel이 마주했던 문제는 의외로 익숙한 상황이었어요. GPU를 팀별로 할당해 운영하다 보니 어떤 팀은 GPU를 충분히 사용하지 못하는 반면, 다른 팀은 자원이 부족해 작업을 기다려야 했던 것이죠.
분명 GPU는 확보해 두었는데, 필요한 곳에서는 부족하다고 느끼는 상황이 발생한 거예요.
Viettel은 이 문제를 해결하기 위해 GPU를 팀별로 나눠주는 기존 방식에서 벗어나, 여러 사용자가 GPU 자원을 유연하게 공유할 수 있는 통합 플랫폼을 구축했습니다.
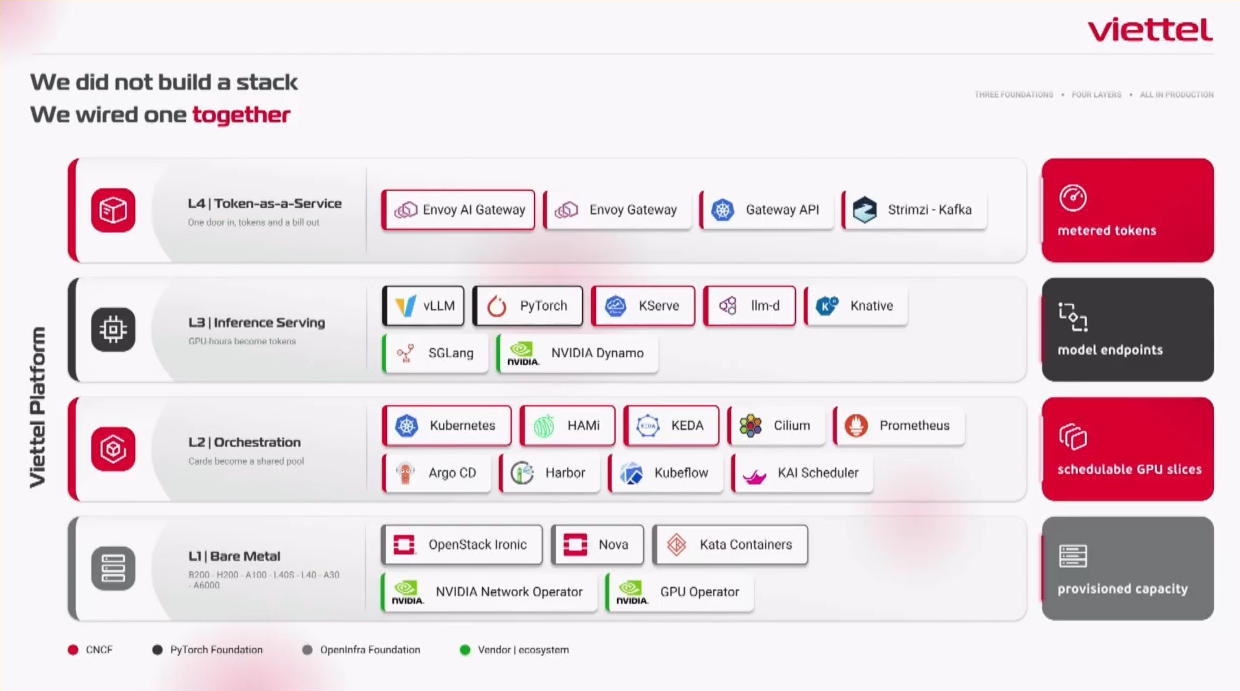
발표에서는 OpenStack 기반 인프라 관리부터 Kubernetes와 HAMi를 활용한 GPU 자원 공유, KEDA 기반 자동 확장, vLLM·KServe·Knative 등을 활용한 AI 추론 서비스까지 다양한 기술을 결합한 4계층 아키텍처를 소개했는데요.
그중에서도 눈길을 끈 개념은 Token-as-a-Service(TaaS)였습니다.
기존에는 AI 서비스를 이용하려면 서버나 GPU를 직접 할당받아야 했다면, 이 방식에서는 API 키와 공통 엔드포인트를 통해 필요한 AI 추론 서비스를 이용할 수 있습니다.
쉽게 말해 사용자가 GPU를 직접 관리하기보다는, 필요한 AI 서비스를 호출해 사용하는 방식으로 바꾼 것이죠.
성과도 꽤 인상적이었습니다. Viettel이 발표한 특정 추론 환경에서는 동일한 처리량을 제공하는 데 필요한 GPU 수를 약 71% 줄일 수 있었고, API를 통한 추론 서비스 이용 준비 시간도 5분 이내로 단축했다고 해요.
물론 모든 환경에서 같은 결과를 얻을 수 있다는 의미는 아닙니다. 하지만 새로운 GPU를 추가하는 것뿐 아니라, 이미 확보한 GPU를 어떻게 공유하고 활용하느냐에 따라서도 인프라 효율이 크게 달라질 수 있다는 점이 흥미로웠어요.
2. 같은 하드웨어로 더 높은 학습 성능을 — Huawei의 HyperParallel
Viettel이 GPU 자원을 더 효율적으로 사용하는 방법을 보여줬다면, Huawei는 조금 다른 질문을 던졌습니다.
"같은 하드웨어를 사용하면서도 AI 모델을 더 빠르게 학습시킬 수 있을까?"
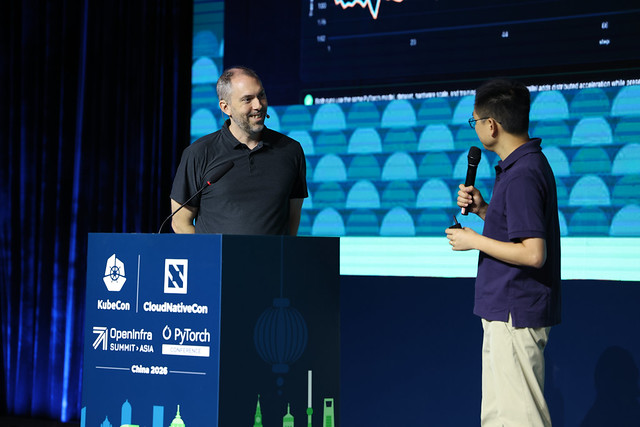
Huawei의 Teng Su와 Shendi Wang은 이 질문에 대한 기술적 접근으로 HyperParallel을 소개했는데요. HyperParallel은 Huawei의 Ascend SuperPoD 환경에 맞춰 설계된 PyTorch 기반 분산 학습 라이브러리입니다.
대규모 AI 모델을 학습할 때는 여러 GPU나 NPU가 연산을 나눠 처리하게 됩니다. 그런데 이 과정에서 가속기끼리 데이터를 주고받는 데 시간이 오래 걸리거나 메모리가 부족해지면, 아무리 연산 성능이 뛰어나더라도 전체 학습 속도가 느려질 수 있어요. HyperParallel은 이러한 문제를 줄이기 위해 하드웨어의 연결 구조를 고려해 연산을 분산하고, 데이터 통신과 연산을 겹쳐 수행하며, 필요에 따라 데이터를 다른 메모리나 저장장치로 옮기는 오프로드(Offload) 기술 등을 활용합니다. 기존 Hugging Face 모델과의 호환성도 고려해 설계했다고 해요.
특히 참관단의 관심을 끈 건 실제 AI 모델을 활용한 학습 성능 비교 시연이었습니다.
Huawei는 Atlas 800 계열 클러스터에서 Qwen3-30B-A3B 모델을 학습시키며 기존 PyTorch FSDP2 + Muon 구성과 HyperParallel을 적용한 구성을 비교했는데요.
두 환경에서 학습 손실이 감소하는 양상인 Loss Convergence는 유사하게 나타났지만, HyperParallel을 적용한 구성에서는 학습 처리량(Throughput)이 200% 이상 향상됐다고 설명했습니다.
동일한 모델을 학습하더라도 데이터 통신과 병렬 처리 방식을 어떻게 구성하느냐에 따라 성능이 크게 달라질 수 있다는 이야기죠.
물론 특정 모델과 하드웨어 구성에서 얻은 시연 결과이지만, 하드웨어의 성능을 충분히 끌어내기 위해서는 이를 뒷받침하는 소프트웨어 최적화도 중요하다는 점을 확인할 수 있었던 발표였습니다.
3. GPU 10만 개의 학습을 지키는 방법 — Meta의 장애 복원력
이번에는 AI 학습의 안정성에 관한 이야기입니다. GPU 수십 개가 아니라 무려 10만 개 규모의 GPU가 함께 AI 모델을 학습하고 있다면 어떨까요?
이렇게 많은 GPU가 동시에 작동하는 환경에서는 일부 장비나 네트워크에 장애가 발생하는 상황도 고려해야 합니다. 대규모 AI 학습에서는 수많은 GPU가 서로 데이터를 주고받으며 하나의 모델을 학습하는데요. 그중 일부 GPU에 문제가 생기면 정상적으로 작동하던 GPU까지 작업을 멈추고 대기해야 하는 상황이 발생할 수 있죠.
문제는 여기서 끝나지 않습니다.
장애가 발생하기 전까지 진행한 학습 상태를 저장하지 못했다면 마지막 체크포인트(Checkpoint)부터 다시 시작해야 할 수도 있거든요. 이 경우 이미 투입한 연산 자원의 일부가 낭비되고 전체 학습 일정도 지연될 수 있습니다.
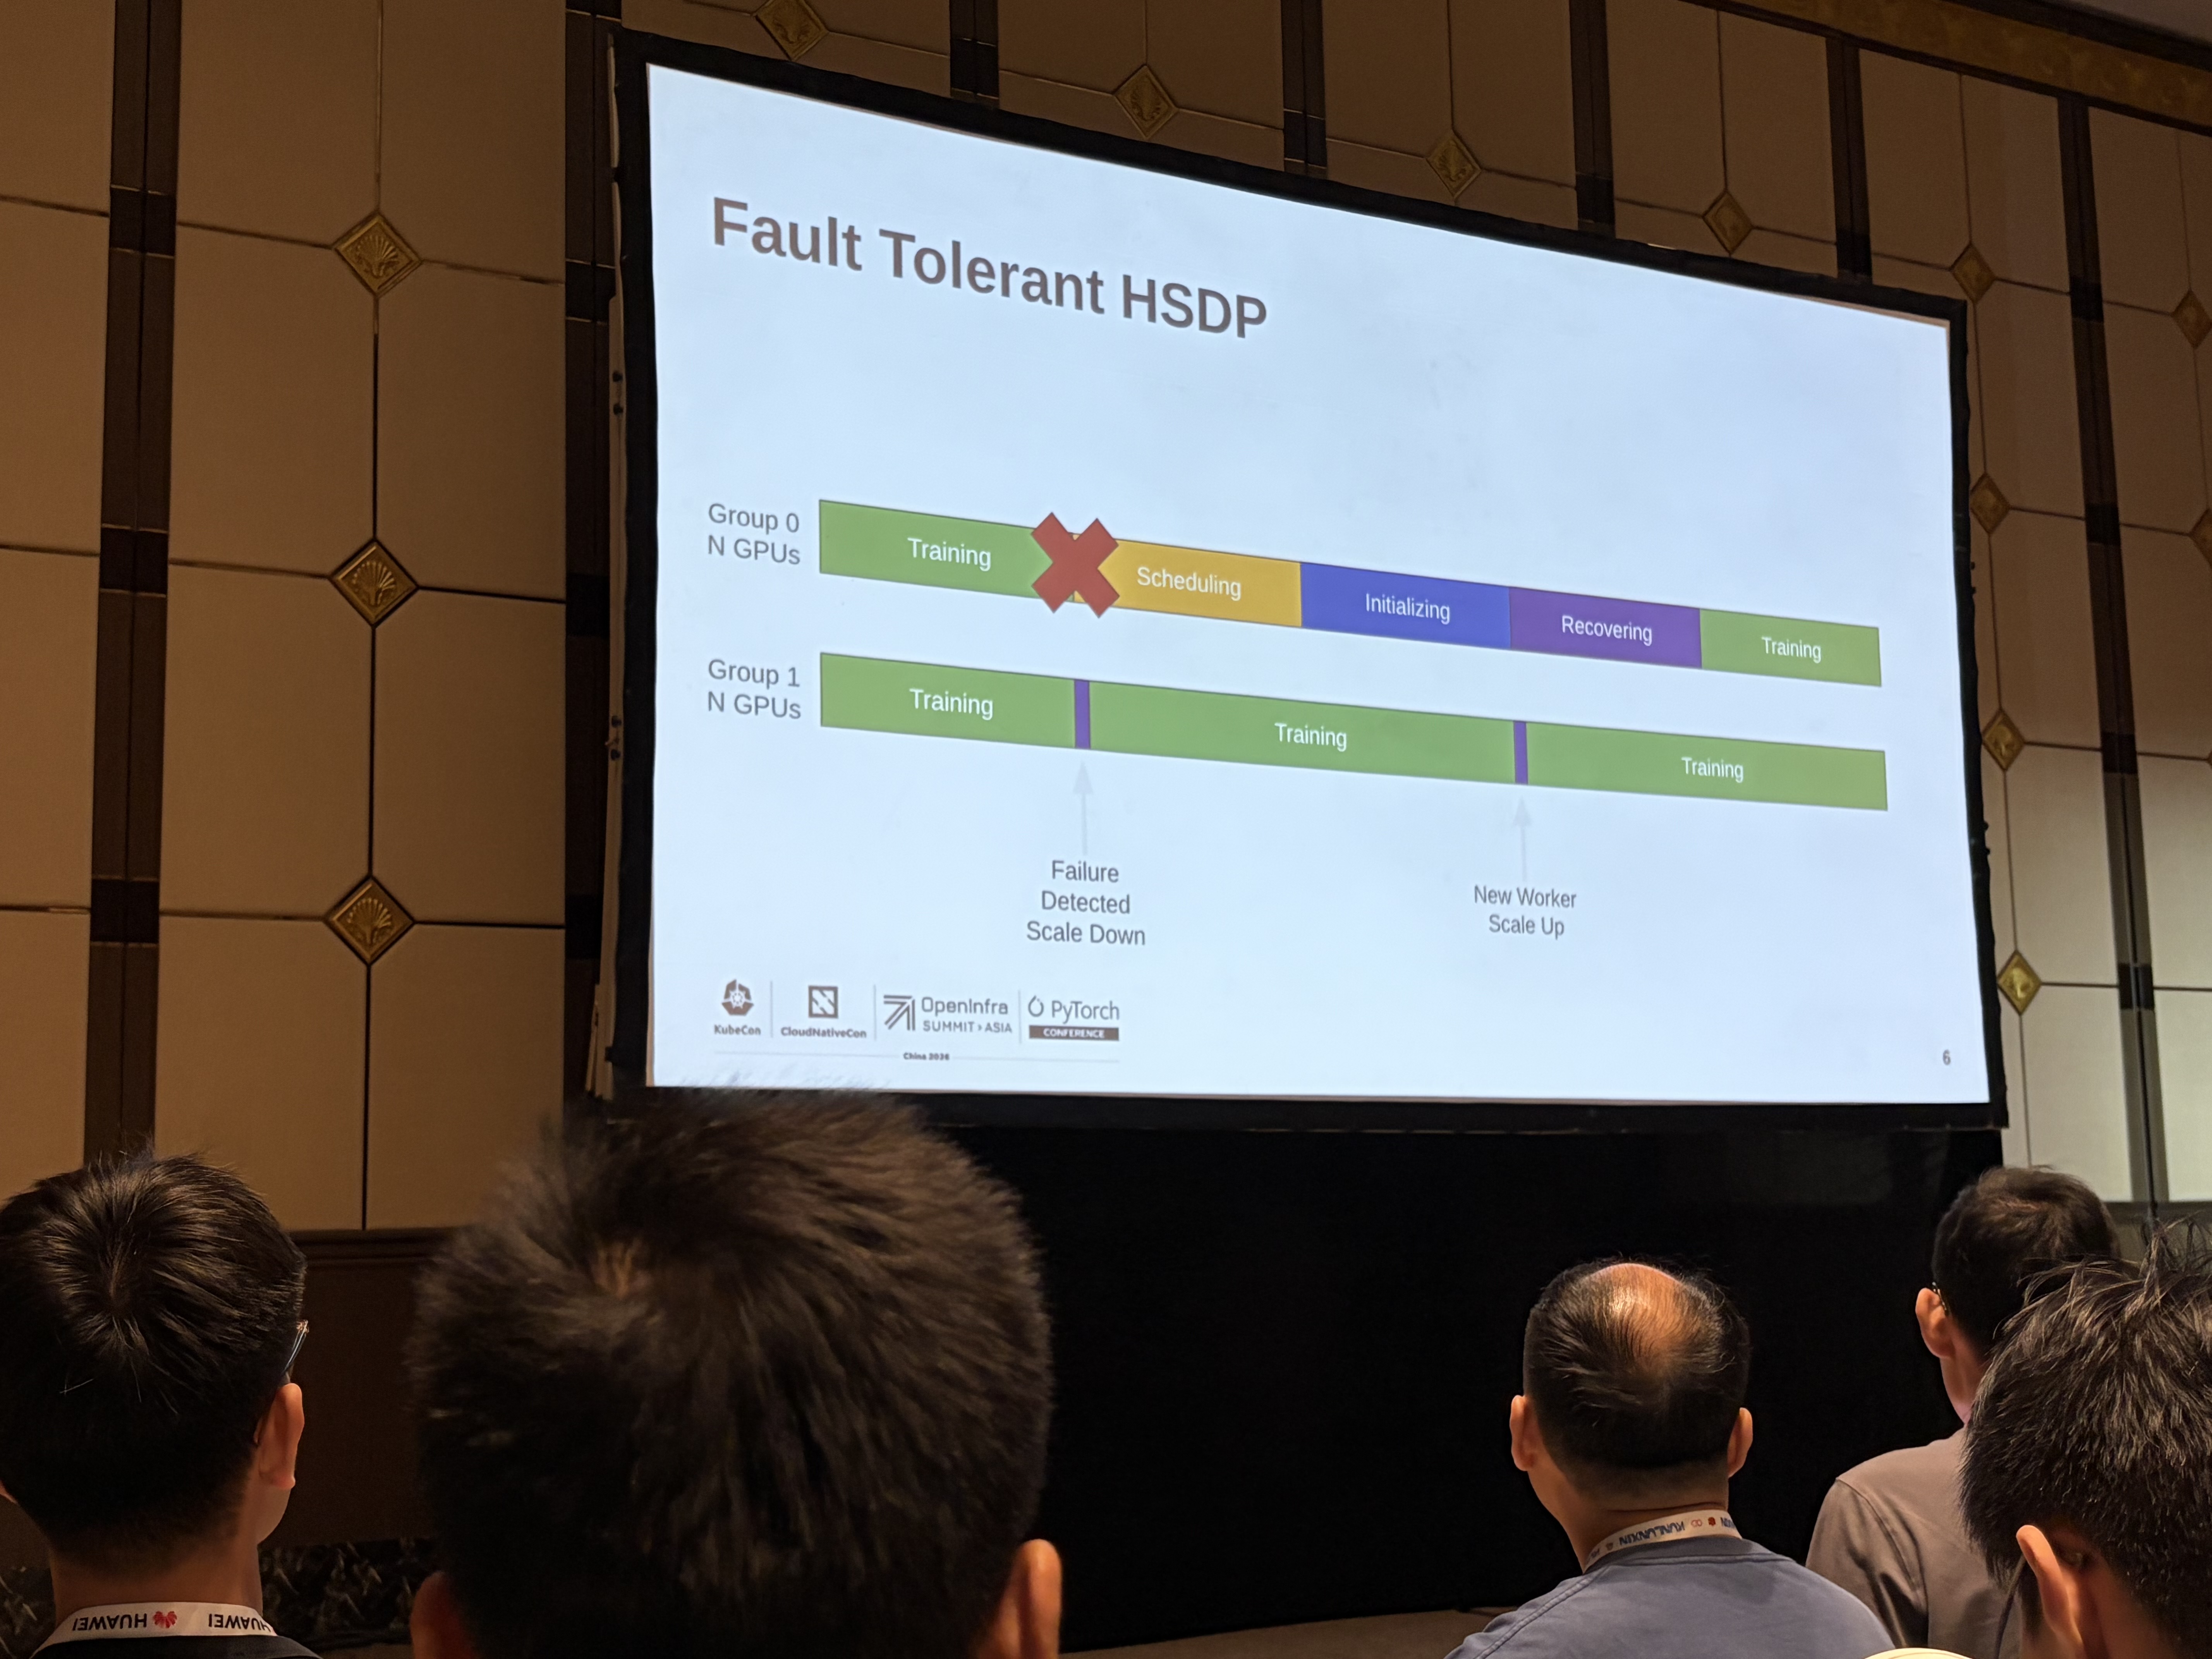
Meta는 이러한 문제에 대응하기 위해 대규모 분산 학습 환경에서 GPU 간 통신을 효율적으로 처리하고 장애 발생 시 학습 중단을 줄이기 위한 기술들을 소개했습니다.
대표적으로 torchcomms와 NCCLX 같은 GPU 통신 기술이 있었는데요. 수많은 GPU가 함께 작업하는 환경에서 통신을 효율적으로 처리하고, 장애 상황에서도 학습을 안정적으로 이어갈 수 있도록 하는 것이 중요한 과제였습니다.
여기서 또 하나 눈길을 끈 기술은 학습 상태를 저장하고 복구하는 체크포인트 기술이었어요.

Meta는 서버 간 메모리와 로컬 저장장치 등을 활용해 학습 상태를 빠르게 저장하는 방식과, 분산 환경에서 상태 정보를 공유하는 torchstore 등의 기술을 소개했습니다.
장애가 발생하더라도 저장된 학습 상태를 활용해 작업을 빠르게 복구하고, 불필요한 재연산과 대기 시간을 줄이기 위한 접근이었죠.
이번 발표를 통해 생각해 볼 수 있었던 건 대규모 AI 학습에서는 장애를 예방하는 것뿐 아니라, 장애가 발생한 이후 얼마나 빠르게 학습을 정상화할 수 있는지도 중요하다는 점이었습니다.
AI 인프라가 대형화될수록 이러한 장애 복원력은 더욱 중요한 운영 기술이 될 것 같았어요.
4. AI가 장애를 분석하고 복구까지 돕는다면? — IBM·Red Hat의 Self-Healing
마지막으로 소개할 세션은 조금 더 미래의 운영 환경을 상상하게 만드는 발표였습니다.
"서비스에 문제가 생겼을 때 AI가 원인을 분석하고, 복구를 돕고, 수정 코드까지 제안한다면 어떨까요?"
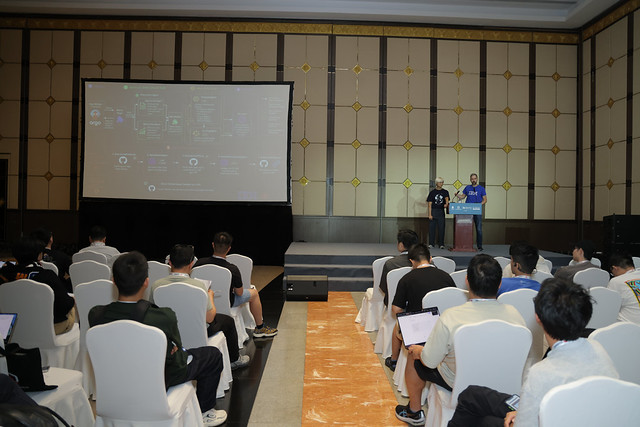
IBM과 Red Hat은 이번 세션에서 AI 에이전트를 활용한 Self-Healing(자가 복구) 소프트웨어 배포 기술을 선보였는데요.
새로운 소프트웨어 버전을 실제 운영 환경에 적용하다 보면 예상하지 못한 오류가 발생할 수 있습니다. 그래서 새로운 버전을 전체 사용자에게 한 번에 적용하기보다는 일부 트래픽에 먼저 적용한 뒤, 상태를 확인하면서 점진적으로 확대하는 카나리 배포(Canary Deployment) 방식을 사용하기도 하죠.
IBM과 Red Hat은 여기에 Kubernetes 기반 배포 자동화 도구인 Argo Rollouts와 AI 에이전트를 결합했습니다.
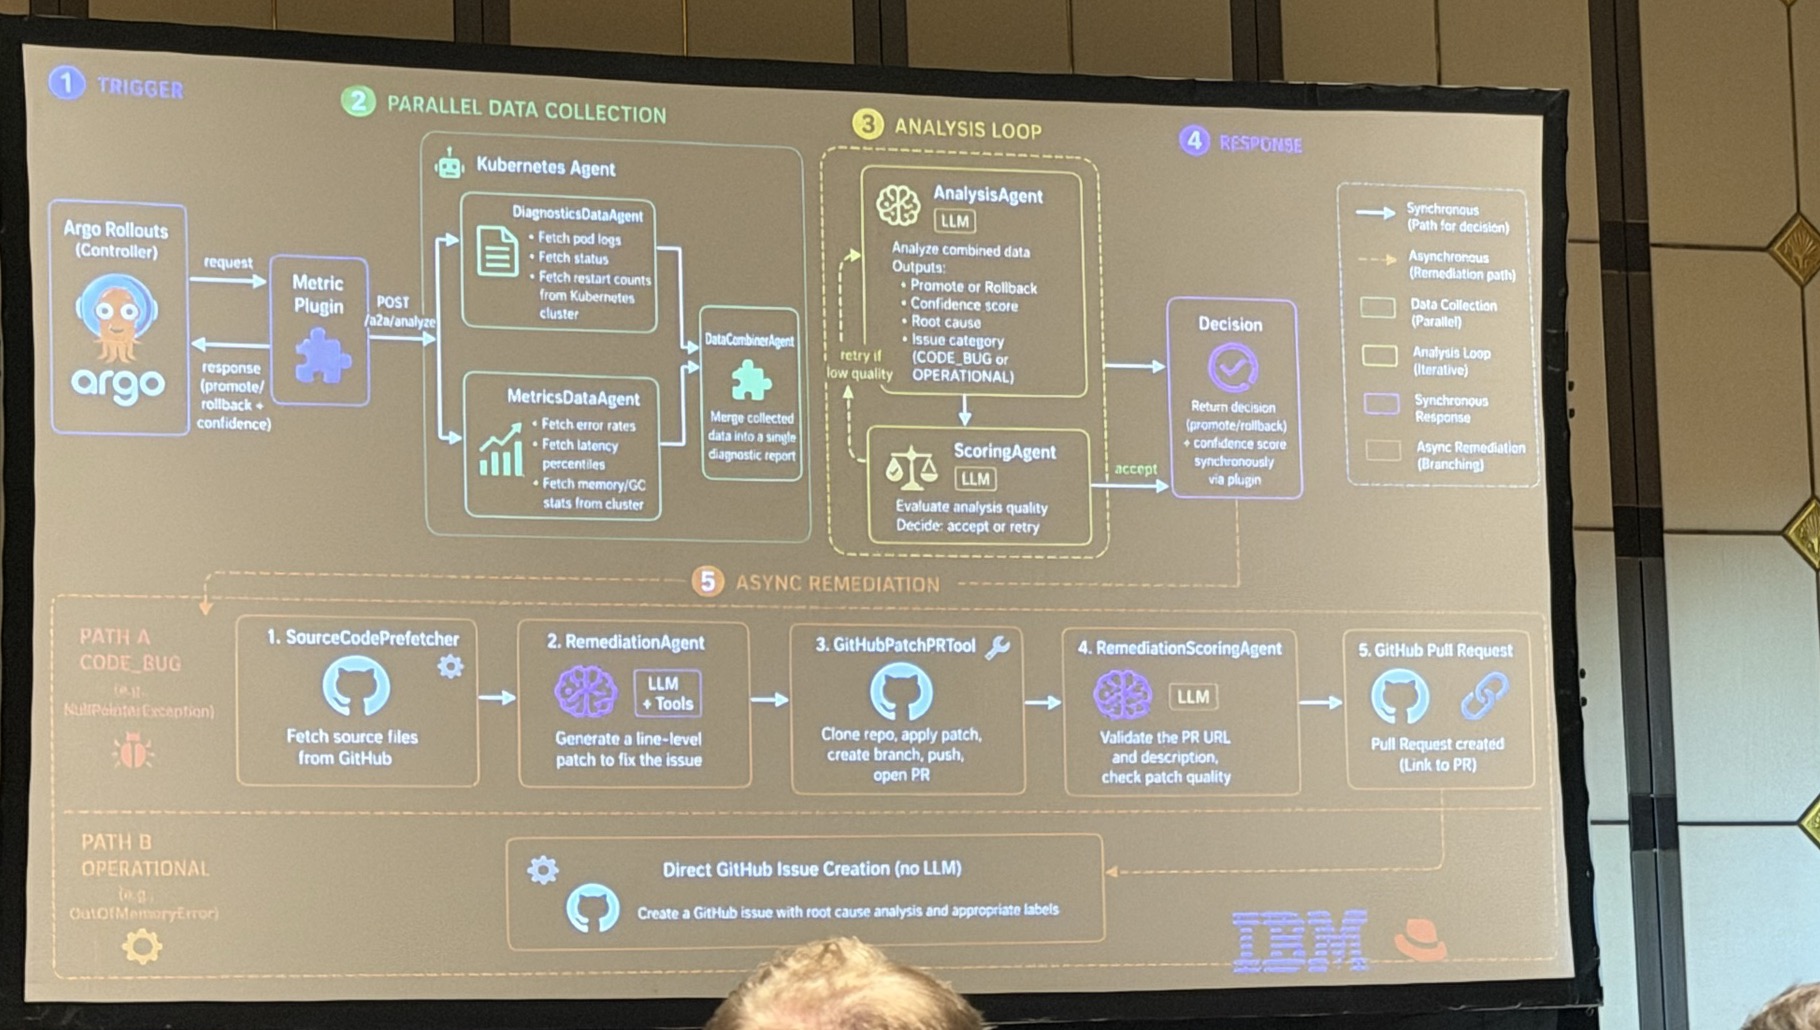
시연 과정도 흥미로웠어요.
먼저 널 포인터 예외(NullPointerException, NPE)가 포함된 소프트웨어를 배포해 의도적으로 오류를 발생시켰습니다.
이후 AI 에이전트가 로그와 실행 상태를 분석하고, 배포 자동화 시스템은 문제가 발생한 버전의 배포를 중단한 뒤 이전의 안정적인 버전으로 되돌리는 롤백(Rollback)을 수행했죠.
그런데 여기서 끝이 아니었습니다.
코딩 에이전트가 오류를 수정할 코드를 제안하고, GitHub에 PR(Pull Request)까지 생성하는 과정도 함께 소개됐거든요.
물론 AI가 작성한 코드를 실제 서비스에 반영하려면 개발자의 검토와 테스트가 필요합니다. 하지만 장애가 발생한 이후 운영자가 원인을 분석하고 수정 작업을 진행하던 과정의 일부를 AI가 지원할 수 있다는 점이 인상적이었어요.
장애를 감지하고 알리는 수준을 넘어 AI가 원인 분석과 복구 과정에 참여하는 운영 자동화의 가능성을 살펴볼 수 있었던 시간이었습니다.
수많은 전시 부스 중 눈길을 끈 Huawei
이번 행사에서는 기술 세션만큼이나 전시장도 흥미로웠습니다. 글로벌 기업들이 선보인 다양한 AI 인프라 장비와 솔루션을 둘러보며 발표에서 접했던 기술들이 실제로 어떻게 구현되고 있는지 살펴볼 수 있었는데요.
그중에서도 참관단에게 특히 인상 깊게 남은 곳은 Huawei 부스였습니다.
대규모 AI 연산을 위한 하드웨어부터 AI 추론 자원을 효율적으로 관리하는 소프트웨어까지, 서로 다른 영역의 기술들을 함께 만나볼 수 있었거든요.
1. 수많은 NPU를 하나의 시스템으로 — Huawei Atlas 950 SuperPoD
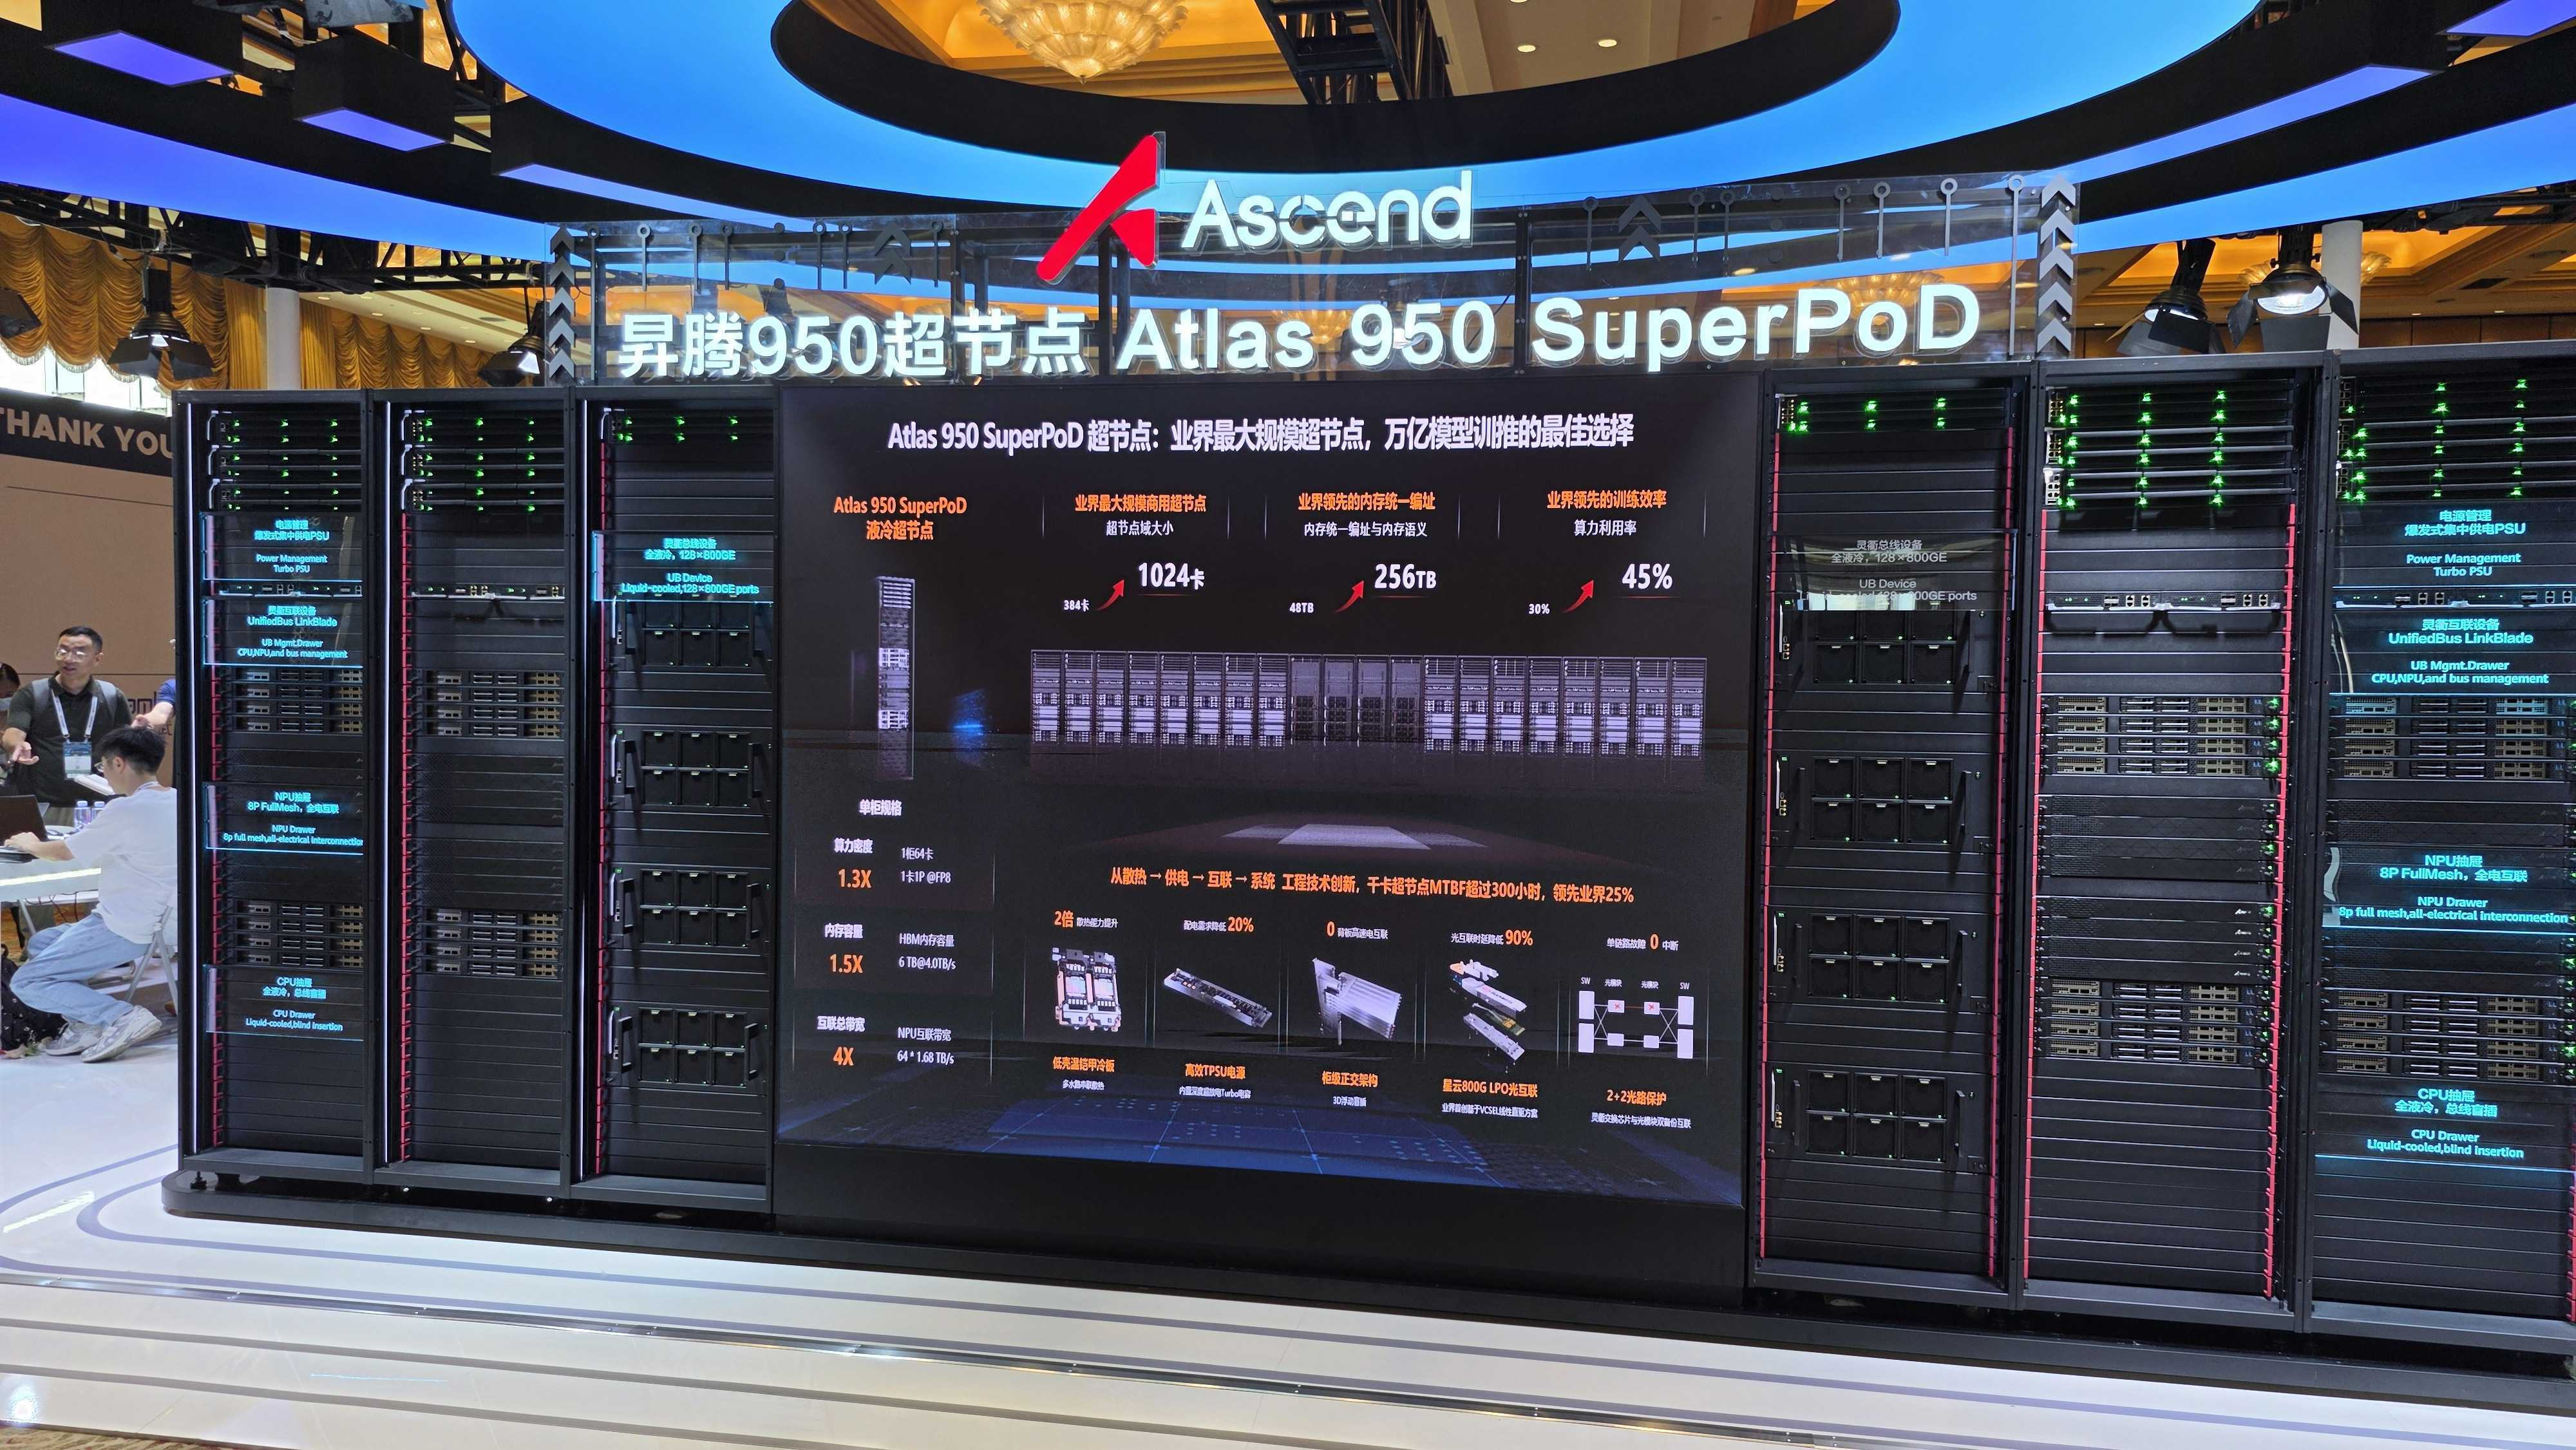
Huawei 부스에서 먼저 눈길을 끈 것은 대규모 AI 컴퓨팅 시스템인 Atlas 950 SuperPoD였습니다.
AI 모델의 규모가 커질수록 하나의 가속기만으로는 필요한 연산을 처리하기 어려워지는데요. 이 때문에 여러 GPU나 NPU를 연결해 하나의 대규모 컴퓨팅 시스템처럼 활용하는 기술이 중요해지고 있습니다.
Atlas 950 SuperPoD 역시 이러한 목적을 위해 설계된 시스템입니다.
Huawei가 공개한 사양에 따르면 UnifiedBus라는 고속 연결 기술을 통해 최대 8,192개의 NPU를 연결할 수 있다고 해요.
숫자만 봐도 상당한 규모인데요. 여기서 중요한 건 가속기를 많이 연결한다는 사실 자체보다, 수많은 NPU가 서로 데이터를 주고받으며 하나의 시스템처럼 작동하도록 설계했다는 점이었습니다.
현장에서는 NPU Drawer와 CPU Drawer, UnifiedBus 연결 장치 등 SuperPoD를 구성하는 하드웨어를 가까이에서 살펴볼 수 있었어요. 특히 눈길을 끈 부분은 대규모 NPU를 연결하고 연동하기 위한 하드웨어 구조였습니다.
AI 학습에서는 여러 가속기가 연산을 나눠 처리하기 때문에 가속기 간 데이터 통신이 원활하지 않으면 전체 성능도 영향을 받을 수 있거든요.
결국 고성능 AI 시스템을 구축하려면 개별 NPU의 성능뿐 아니라, 이를 연결하는 통신 구조와 네트워크, 전력·냉각 인프라까지 함께 고려해야 하는 것이죠.
앞서 Huawei의 HyperParallel 발표에서 소프트웨어를 활용한 학습 성능 최적화 기술을 살펴봤다면, 이번 전시에서는 그러한 대규모 AI 연산을 뒷받침하는 하드웨어 구성을 만나볼 수 있어 더욱 흥미로웠습니다.
2. AI 추론도 단계별로 자원을 관리한다 — Huawei CCE와 Kthena

Huawei 부스에서 또 하나 관심을 끈 기술은 CCE(Cloud Container Engine) 관련 전시에서 소개된 Kthena였습니다.
Kthena는 Kubernetes 기반으로 대규모 언어모델(LLM)의 추론 서비스를 효율적으로 운영하기 위한 오픈소스 프로젝트인데요.
여기서 흥미로웠던 건 AI가 답변을 생성하는 과정을 서로 다른 단계로 나눠 관리한다는 점이었습니다.
우리가 AI 챗봇에 질문을 입력하면 AI는 곧바로 답변을 만들어내는 것처럼 보이죠. 하지만 내부적으로는 크게 두 가지 과정이 진행됩니다. 먼저 사용자가 입력한 질문과 대화 문맥을 처리하는 Prefill 단계가 있고, 이후 답변을 한 토큰씩 생성하는 Decode 단계가 있습니다.
그런데 두 단계는 사용하는 컴퓨팅 자원의 특성이 서로 달라요.
Prefill은 입력된 문맥을 처리하는 과정에서 상대적으로 많은 연산이 필요하고, Decode는 답변을 순차적으로 생성하면서 메모리 접근과 데이터 전송 성능이 중요해집니다.
이처럼 필요한 자원이 서로 다른데 모든 작업을 동일한 방식으로 처리한다면 어떨까요? 일부 자원에는 부담이 집중되는 반면 다른 자원은 충분히 활용되지 않을 수도 있겠죠.
Kthena는 이러한 차이를 고려해 Prefill과 Decode를 분리해 운영하는 방식을 지원합니다. 각 단계에 필요한 자원을 배치하고, 요청을 적절한 인스턴스로 전달하거나 작업량에 따라 개별적으로 확장할 수 있도록 하는 것이죠.
쉽게 말해 모든 AI 추론 자원을 일괄적으로 늘리는 대신, 실제 작업의 특성과 수요에 맞춰 필요한 자원을 효율적으로 운영하는 방식이라고 이해할 수 있습니다.
앞서 Viettel의 발표에서 GPU 자원을 공유해 활용률을 높이는 접근을 살펴봤다면, Kthena에서는 AI 추론 작업을 단계별로 나눠 자원을 더욱 세밀하게 관리하는 방법을 살펴볼 수 있었어요.
상하이에서 확인한 AI 인프라의 변화
이번 KubeCon China 2026 참관은 AI 인프라를 바라보는 시야를 한층 넓힐 수 있었던 시간이었습니다.
키노트와 기술 세션에서는 GPU 자원 관리와 학습 성능 최적화부터 대규모 분산 학습의 장애 복원력, AI 에이전트를 활용한 운영 자동화까지 다양한 기술적 시도를 만나볼 수 있었어요. 전시장에서는 이러한 기술을 뒷받침하는 하드웨어와 소프트웨어를 직접 살펴보며 AI 인프라의 발전 방향을 더욱 생생하게 느낄 수 있었죠.
이번 행사에서 특히 인상 깊었던 건 AI 인프라의 경쟁력이 더 많은 GPU를 확보하거나 고성능 장비를 도입하는 것만으로 결정되지는 않는다는 점이었습니다.
GPU 자원을 효율적으로 활용하는 방법부터 학습 성능을 높이고 장애에 대응하는 기술까지, 현장에서는 AI 인프라를 더욱 안정적이고 효율적으로 운영하기 위한 다양한 노력을 확인할 수 있었어요. 특히 AI 에이전트를 활용한 운영 자동화 사례를 보면서 인프라 운영 방식도 빠르게 변화하고 있다는 점이 인상 깊었습니다.
상하이 현장에서 kt cloud 참관단이 직접 보고 들은 이야기들, 여러분도 흥미롭게 읽으셨나요?
이번 현장 스케치가 빠르게 변화하는 AI 인프라 기술과 그 흐름을 이해하는 데 조금이나마 도움이 되었기를 바랍니다.
앞으로도 글로벌 기술 현장에서 발견한 새로운 기술과 흥미로운 인사이트를 여러분께 생생하게 전해드리겠습니다.
그럼, 다음 현장 스케치에서 또 만나요! 🙋♂️
🧐 현장에서 담아온 한마디
유영주 님 (Cloud NW운영팀)
🌐 "이번 행사에서 특히 느낀 건 AI 인프라에서 네트워크의 역할이 정말 중요해졌다는 거예요. GPU를 빠르게 연결하는 것뿐 아니라, 장애가 발생했을 때 AI 학습에 어떤 영향을 주고 얼마나 빨리 정상화되는지까지 살펴봐야겠더라고요. 특히 Meta의 장애 복원력 사례와 Huawei SuperPoD 전시가 기억에 남았습니다."
박필조 님 (NW기술팀)
🔗 "네트워크 장비나 회선이 복구됐다고 해서 AI 학습도 바로 정상화되는 건 아니겠더라고요. 앞으로는 네트워크 자체의 복구시간뿐 아니라, 장애가 실제 GPU 학습 작업에 미치는 영향과 정상화에 걸리는 시간까지 검증하는 것이 중요하다고 느꼈습니다."
옥보민 님 (DC NW운영팀)
🛠️ "AI 인프라에서는 네트워크 장비의 상태만 확인하는 것으로는 부족하겠다는 생각이 들었어요. 포트 상태나 패킷 손실뿐 아니라 AI 서버와 NIC, 실제 학습 작업의 상태까지 함께 볼 수 있다면 장애 원인과 영향을 훨씬 빠르게 파악할 수 있을 것 같습니다."
이치현 님 (Cloud통합관제팀)
📡 "Viettel과 IBM·Red Hat의 발표를 보면서 AI 인프라 운영도 점점 더 똑똑해지고 있다는 걸 느꼈어요. 특히 AI 에이전트가 장애 징후를 분석하고 운영자의 대응까지 지원하는 모습이 인상적이었습니다. 앞으로 통합관제가 나아갈 방향을 생각해 볼 수 있었던 시간이었어요."
김혜원 님 (Cloud SW운영팀)
🧩 "새로운 기술이 나올 때마다 플랫폼을 처음부터 다시 만들 필요는 없겠더라고요. 여러 기업의 사례를 보면서 기존 OpenStack과 Kubernetes를 잘 이해하고 필요한 기능을 결합하는 역량이 중요하다고 느꼈어요. 오픈소스는 비용 절감뿐 아니라 기술과 운영의 주도권을 확보하는 데도 중요한 역할을 할 것 같습니다."
유지연 님 (Data플랫폼팀)
🔐 "AI 에이전트가 더 많은 일을 수행하게 될수록 이를 안전하게 관리하는 기술도 중요해지겠다는 생각이 들었어요. 특히 에이전트의 신원과 권한을 분리해 관리하고, 실행 상태를 관찰하며 보안 정책을 적용하는 방식이 인상적이었습니다. AI를 잘 활용하는 것만큼 안전하게 운영하는 것도 중요하다는 걸 느꼈습니다."
이종혁 님 (Platform엔지니어링팀)
⚙️ "실제 서버를 운영하다 보면 반복적인 수작업이 생각보다 많거든요. 이번에 bootc와 Cluster API 사례를 보면서 표준화된 이미지와 선언적 구성으로 운영 방식을 바꿀 수 있겠다는 생각이 들었어요. AI로 운영을 자동화하더라도 조치에 대한 검증과 승인, 책임 기준은 명확해야 한다는 점도 인상적이었습니다."
노희경 님 (Cloud플랫폼팀)
☁️ "Kubernetes가 이제 컨테이너를 실행하는 기술을 넘어 GPU와 네트워크, 보안, AI 에이전트까지 관리하는 플랫폼으로 발전하고 있다는 점이 흥미로웠어요. 결국 다양한 기술을 얼마나 잘 통합하고 안정적으로 운영할 수 있도록 설계하느냐가 앞으로 플랫폼의 중요한 경쟁력이 될 것 같습니다."
관련 / 출처 REFERENCES
- https://www.lfopensource.cn/kubecon-cloudnativecon-openinfra-summit-pytorch-conference-china/program/schedule/
- https://www.cncf.io/announcements/2026/06/18/kubecon-cloudnativecon-openinfra-summit-and-pytorch-conference-unite-in-china-to-scale-ai/
- https://arxiv.org/abs/2602.00277
- https://www.huawei.com/cn/news/2026/7/atlas-950-superpod
- https://kthena.volcano.sh/blog/release-v1.0.0
- kt cloud 임직원 KubeCon China 2026 참관기 8건
↗
'kt cloud Story > Tech Events' 카테고리의 다른 글
| [현장 스케치] 당신의 비즈니스를 위한 AX, kt cloud summit 2026 (0) | 2026.09.23 |
|---|---|
| [kt cloud summit 2026] AX에 필요한 핵심 기술과 구축·운영 경험을 한자리에서 만나보세요 (0) | 2026.08.24 |
| [kt cloud summit 2026] 사전 등록이 시작되었습니다. (0) | 2026.07.09 |
| [TECH UP] IT 취업 준비생을 위한 Cloud·AI 실무 교육, kt cloud TECH UP (0) | 2025.11.28 |
| [세션 리포트] OpenInfra Summit Europe 2025:kt cloud의 OpenStack-Kubernetes 클라우드 네이티브 CSP 구축 사례 (0) | 2025.11.25 |