
요약 SUMMARY
인증·스토리지 문제와 해결 과정을 다룹니다.
토큰 서명 키 공유, 세션 관리, 스토리지 분리 및 장애 시 자동 전환을 위한 트래픽 구성 전략을 정리합니다.
#Harbor #Gitea #멀티AZ #ActiveActive #고가용성
왜 Active-Active로 바꿨나
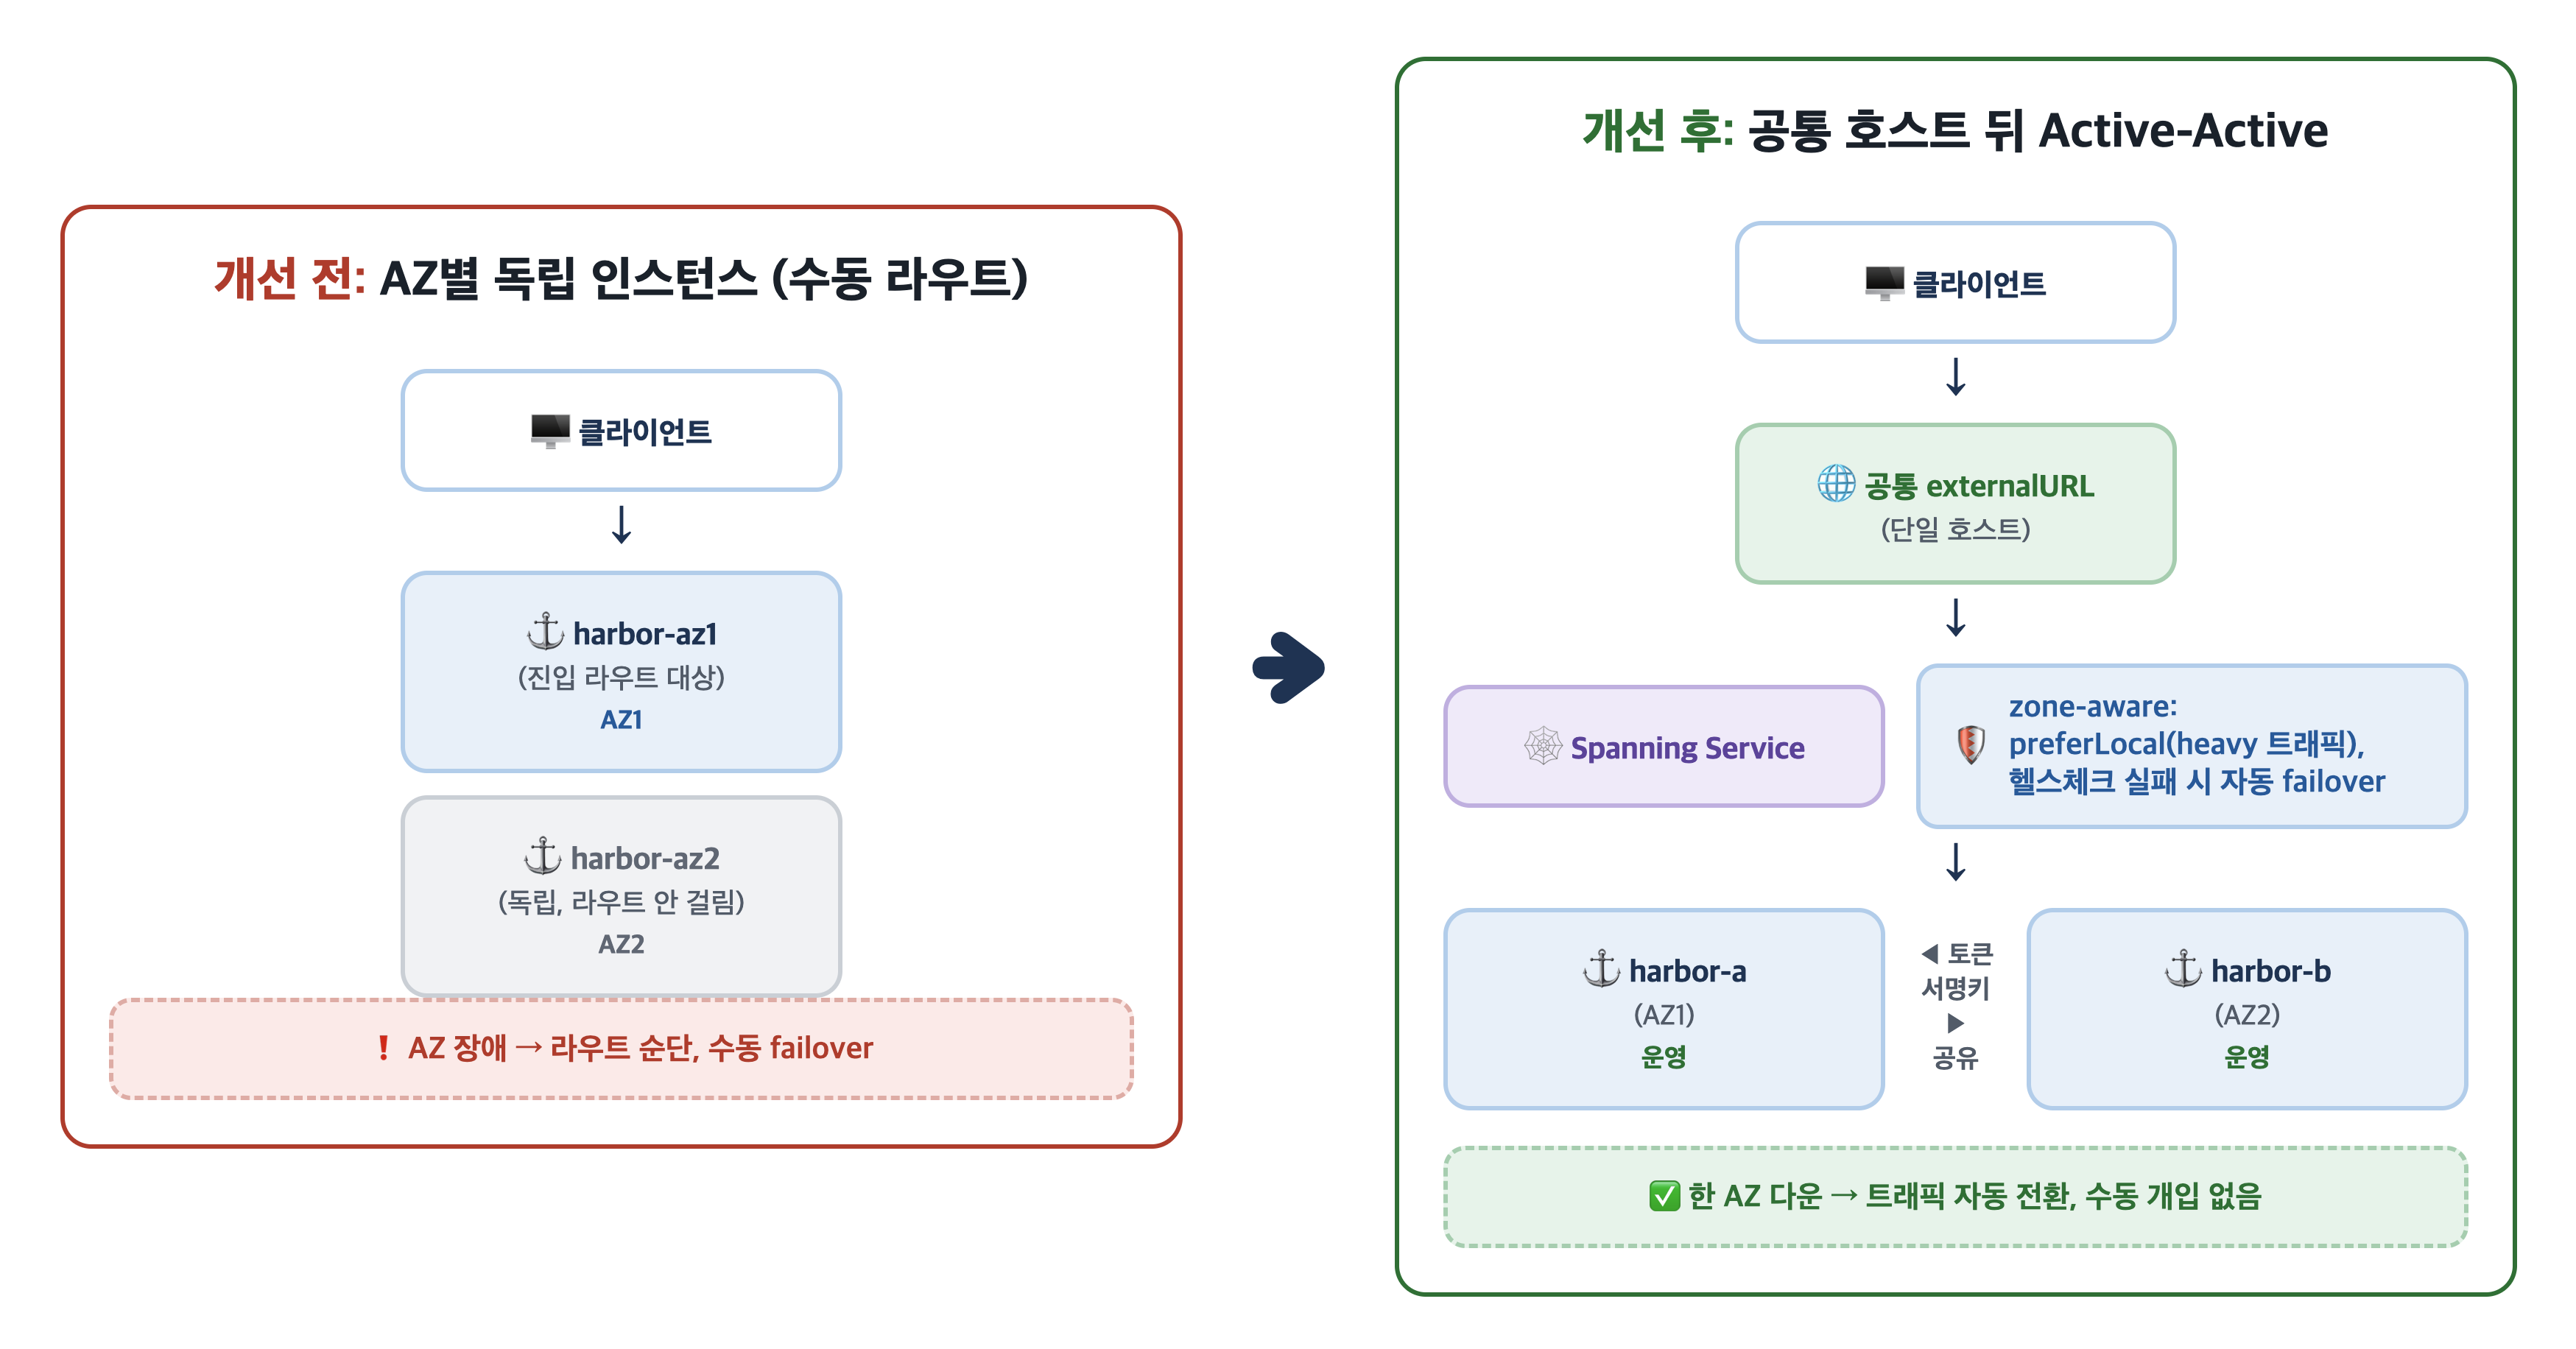
레지스트리랑 git이 막히면 CI가 통째로 섭니다. 이미지 pull이 안 되면 배포가 멈추고, git clone이 안 되면 파이프라인이 멈춥니다. 원래는 단일 AZ로 돌렸는데, 그 AZ가 죽으면 그대로 멈추니 HA가 안 됐습니다. 그래서 두 AZ를 하나로 묶은 멀티 AZ 환경(Federated 클러스터)을 구성했습니다. 여기서 중요한 건, AZ는 둘이지만 클러스터는 하나라는 점입니다. 이 단일 클러스터 위에 AZ마다 별도 deployment를 띄우고, 그 둘을 하나의 서비스처럼 묶는 것, 이게 출발점이었습니다.
그런데 처음엔 그 '하나로 묶기'가 안 돼 있었습니다. AZ마다 인스턴스는 독립으로 각각 떠 있었지만 진입 라우트는 한 AZ만 가리켰고, 그 AZ가 흔들리면 사람이 라우트를 다른 AZ로 수동으로 돌려야 했습니다. AZ 하나에 기대는 구조라 진짜 HA는 아니었죠.
목표는 단순했습니다. 주소는 하나, 뒤에선 두 AZ가 같이 받는 구조. 한쪽 AZ가 죽어도 사용자는 모르게. 문제가 하나 있었습니다. 레지스트리와 git은 Stateful합니다. 토큰이든 파일이든 상태를 들고 있어서, 인스턴스만 둘로 늘리면 오히려 깨졌습니다.
인스턴스가 왜 하나가 아니라 둘일까요. 우리는 AZ마다 인스턴스와 스토리지를 독립으로 두고, 그 사이를 복제로 동기화합니다. 그러다 보니 인스턴스가 둘로 갈라지고, 갈라진 둘 사이의 상태를 맞춰줘야 하는 숙제가 생깁니다. 뒤에 나오는 토큰 키와 세션 문제가 여기서 출발합니다.
| 축 | 개선 전 | 개선 후 |
| 진입점 | AZ별 개별 호스트/라우트 | 공통 externalURL 하나 + 스패닝 Service |
| 인스턴스 | AZ별 독립 인스턴스(진입은 한쪽) | A, B 두 릴리스가 동시 서비스 |
| 토큰 | AZ별 서명 키 | 서명 키 공유(어느 AZ든 유효) |
| 트래픽 | 고정 라우트 | zone-aware(preferLocal) + 헬스체크 failover |
| 컷오버 | 해당 없음 | 운영 라우트 backendRef 2단계 무중단 전환 |
먼저 진입 호스트를 하나로
제일 먼저 진입 호스트를 합쳤습니다. Harbor는 릴리스를 둘(A, B) 띄우고, 그 앞에 두 AZ의 파드를 같이 묶는 스패닝 Service를 뒀습니다. 외부 주소(externalURL)는 하나로 통일하고, AZ마다 따로 있던 라우트(per-AZ HTTPRoute)는 지웠습니다. 쓰는 쪽에선 접속 주소가 하나입니다. 요청이 뒤에서 어느 AZ로 가는지는 몰라도 됩니다.
진짜 문제는 토큰이었다
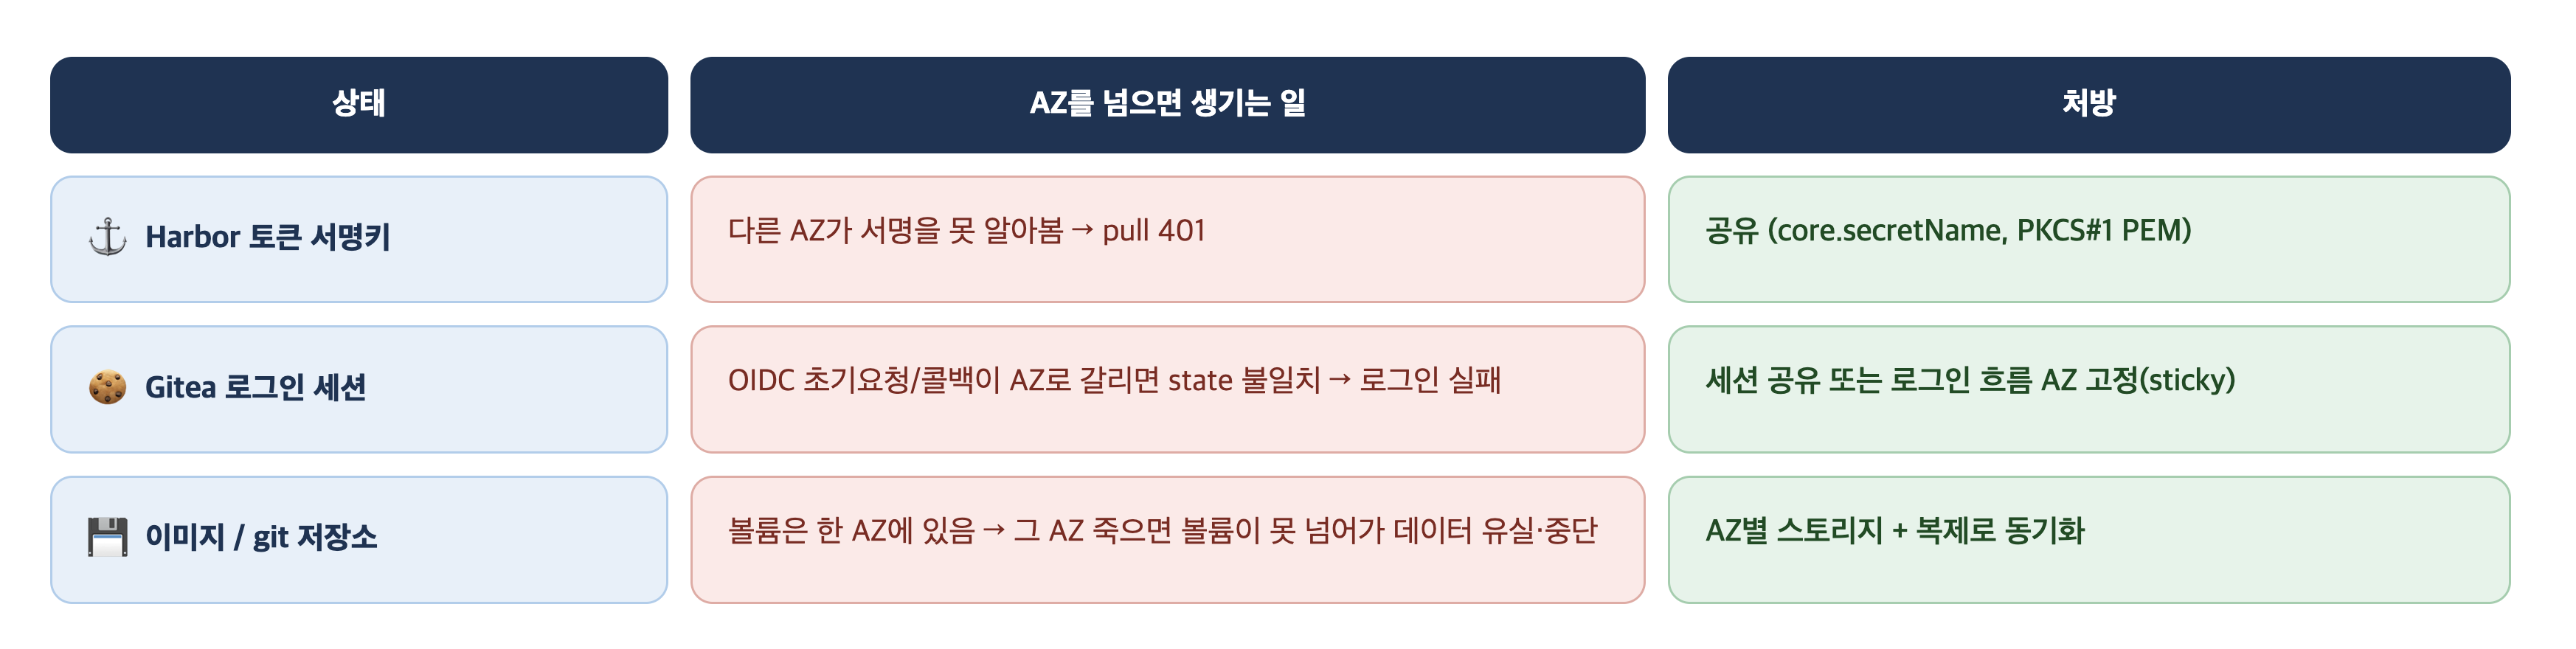
여기서 Statelful 서비스의 함정이 나옵니다. Harbor는 이미지를 주고받을 때 안에서 토큰을 발급하고 검증합니다. 이 토큰은 서명 키로 서명하는데, A와 B가 서로 다른 키를 쓰면 사달이 납니다. A에서 토큰을 받은 요청이 다음에 B로 가면, B는 그 서명을 모릅니다. 그냥 거부합니다. 겉으로는 'pull이 가끔 401 뜬다'는, 재현도 잘 안 되는 증상으로 옵니다.
그래서 두 인스턴스가 서명 키를 공유하게 했습니다. Harbor는 이 키를 시크릿으로 물고 있어서(core.secretName), 같은 시크릿을 양쪽에 물리면 어느 AZ로 가든 같은 키로 발급하고 검증합니다. 확인은 간단합니다. AZ-A에서 받은 토큰을 AZ-B에 던져 200이 나오는지, 반대 방향도 200인지 봅니다. 여기서 401이면 키가 안 맞는 겁니다. 이 키 공유가 사실상 이번 개편의 심장부였습니다.
여기 함정이 하나 더 있었습니다. Harbor는 이 서명 키를 PKCS#1 형식의 PEM으로 기대합니다. 그런데 처음 넣은 키는 PKCS#8이었고, 포맷이 안 맞으니 인증이 깨졌습니다. 키를 PKCS#1로 변환해 다시 넣고 Harbor-core를 재기동하고 나서야 맞아떨어졌습니다. 키를 공유한다는 결정만큼이나, 그 키가 어떤 포맷이어야 하는지가 중요했습니다.
평소엔 가까이, 죽으면 옆으로
두 AZ가 다 살아있으면 다음 고민은 '어디로 보낼까'입니다. AZ를 넘나드는 트래픽은 느리고 대역폭도 씁니다. 그래서 평소엔 요청이 들어온 AZ의 인스턴스를 먼저 쓰게(preferLocal) 하고, 그게 헬스체크에서 죽으면 다른 AZ로 넘깁니다. Gitea는 이걸 트래픽 정책(zone-aware preferLocal + TCP 헬스체크)으로 박아뒀습니다. 평소엔 로컬로 붙어 빠르고, 한 AZ가 죽으면 사람이 안 붙어도 살아있는 쪽이 받습니다. failover가 라우트 수술이 아니라 그냥 기본 동작이 된 겁니다.
다만 이 preferLocal이 모든 트래픽에 걸리는 건 아닙니다. 이미지 pull처럼 무거운 트래픽에만 zone-aware가 적용되고, 가벼운 요청들은 그냥 양쪽 AZ로 분산됩니다(로그인 UI는 stickiness로 한쪽에 붙지만 그건 예외). 지금 kube-ovn 구조상 진입 지점에서 envoy gateway까지 구간은 zone-aware가 보장되지 않기 때문에, 무거운 트래픽 위주로 지역성을 챙기는 셈입니다.
갈아타기는 2단계로
이미 돌고 있는 서비스를 새 구조로 옮기는 거라, 컷오버가 제일 위험했습니다. 운영 라우트 목적지(backendRef)를 한 번에 안 바꾸고 2단계로 나눴습니다. 트래픽을 조금씩 새 구조로 넘기며 멀쩡한지 보고, 안정되고 나서 옛 인스턴스(harbor-az1)를 내렸습니다. 언제든 되돌릴 구멍을 남겨둔 겁니다.
Gitea는 세션이 발목을 잡았다
Gitea도 방향은 같았습니다. 두 AZ에 인스턴스를 두고 공통 진입으로 묶었습니다. 그런데 Gitea엔 토큰과 다른 종류의 상태가 있었습니다. 로그인 세션입니다.
Gitea는 IdP로 OIDC 로그인을 합니다. OIDC 로그인은 최소 두 번 왕복합니다. 처음 로그인 요청을 보내고, IdP를 거쳐 콜백으로 돌아옵니다. 이 두 번이 서로 다른 AZ로 갈리면 문제가 생깁니다. 각 Gitea 인스턴스의 세션이 분리돼 있어서, 처음 요청을 받은 AZ가 만든 state를 콜백을 받은 다른 AZ가 모릅니다. 그러면 로그인이 간헐적으로 실패합니다. 재현이 들쭉날쭉해 잡기 까다로운 종류죠.
처방은 상태의 성격을 따라갑니다. 세션은 로그인 한 흐름을 같은 AZ로 고정하거나(sticky) 세션 저장소를 공유해서 풉니다. git 저장소 자체는 파일 볼륨이라 또 다릅니다. 같은 볼륨을 두 AZ가 동시에 잡으면 Multi-Attach가 나니, 이건 인스턴스마다 볼륨을 갈라 소유를 명확히 합니다.
정리하면 상태마다 처방이 다릅니다. 토큰 서명키는 공유하고, 로그인 세션은 공유하거나 흐름을 고정하고, 파일 볼륨은 갈라서 소유를 정합니다. 같은 Active-Active여도 상태의 종류가 처방을 정했습니다.
Vault랑 ArgoCD는 왜 안 건드렸나
같은 클러스터라도 전부 이 방식으로 바꾼 건 아닙니다. Vault와 ArgoCD는 손댈 게 거의 없었습니다. 둘 다 replica(pod 여러 개)를 두 AZ에 나눠 띄우기만 하면 되는 쪽이라서요.
Vault는 이미 Raft 클러스터입니다. 노드가 여러 AZ에 흩어져 있고, 리더와 팔로워가 상태를 합의(consensus)로 맞춥니다. 이번 작업에서 Vault는 pod를 AZ에 걸쳐 분산되게 배치를 맞추고 quorum만 확인하면 끝이었습니다. Harbor처럼 인스턴스를 세워 서명 키를 공유하는 일은 필요 없습니다. 이중화가 구조 자체에 들어 있으니까요.
ArgoCD는 더 단순합니다. 구성요소 대부분이 상태 없는 replica라, 같은 pod를 여러 개 띄워 두 AZ에 나눠 뜨게만 하면(스케줄러 분산이나 topologySpread) 그걸로 HA가 됩니다. Harbor처럼 인스턴스마다 상태가 갈리는 게 아니라 어느 pod가 요청을 받아도 똑같으니, 서명 키를 공유할 것도 세션을 맞출 것도 없습니다. 이번에도 ArgoCD는 replica가 두 AZ에 떠 있는지와 HA 상태만 확인했습니다.
차이는 여기 있었습니다. ArgoCD처럼 상태가 없거나 Vault처럼 상태를 스스로 복제하는 서비스는, pod를 여러 개 띄워 AZ에 나눠 뿌리는 것만으로 이중화가 됩니다. 반대로 Harbor 토큰, Gitea 세션, 파일 볼륨처럼 인스턴스마다 갈리는 상태를 쥔 서비스는 그냥 뿌리면 깨지니까, 공유하거나 갈라줘야 했습니다. 그 갈림이 이번 작업의 난이도를 정했습니다.
정리
인스턴스를 둘로 늘리는 건 시작일 뿐이었습니다. 실제로 손이 간 건 세 군데입니다. 진입점을 하나로 합치고, 토큰 서명 키를 공유하고, 트래픽을 zone-aware로 흘리며 failover를 기본으로 깔아둔 것. 옮기는 것도 2단계로 나눠 되돌릴 구멍을 남겼습니다.
레지스트리나 git처럼 상태를 가진 도구를 여러 AZ에서 같이 돌리려는 분이라면, 인스턴스 개수보다 '뭘 공유하고 뭘 가를지'를 먼저 정하시길 권합니다. 토큰처럼 신뢰의 근거가 되는 건 공유해야 어디로 붙어도 안 끊기고, 파일 볼륨처럼 무거운 건 소유를 박아야 안 부딪힙니다.
자주 묻는 질문 FAQ
관련 / 출처 REFERENCES
'Tech Story > DevOps & Container' 카테고리의 다른 글
| [활용 사례] AI와 GitOps의 만남: Chkk MCP 기반 쿠버네티스 애드온 업그레이드 실전기 (0) | 2026.11.11 |
|---|---|
| [기술 가이드] Kubernetes의 핵심 변화: DRA를 통한 GPU 자원 동적 할당 (1) | 2026.11.04 |
| [기술해설] Agentic AI 시대의 Kubernetes 인프라 활용: Agent Sandbox 입문 (0) | 2026.10.08 |
| [플랫폼설계] DevOps에서 Platform Engineering으로: kt cloud의 여정 (0) | 2026.10.02 |
| [활용사례] DevOps 엔지니어가 주목하는 MCP 생태계와 kt cloud PLATFORM 적용기 (0) | 2026.09.23 |