
요약 SUMMARY
네트워크·스토리지 문제 해결과 Cinder NFS 블록 스토리지 연결 및 재부팅 검증 과정을 다룹니다.
Helm 차트 설정 오류와 컨테이너 이미지 변경 문제의 원인 및 해결 방안을 정리합니다.
#OpenStack #Cinder #NFS #Kubernetes #트러블슈팅
1. 1·2부 다음 이야기
1부에서는 "노트북 한 대에 OpenStack 핵심 컴포넌트(keystone · glance · nova · neutron · cinder · placement)가 뜨고, ArgoCD·Flux가 git을 watch하면서 배포 이후의 변경도 OTA로 따라오는" 흐름을 정리했습니다. 2부에서는 그 안에서 평문 자격증명이 어디에도 박히지 않도록 Vault → ESO → K8s Secret으로 흐르는 경로를 다뤘습니다.
한 가지 변경이 있습니다. 1부 시점에는 UTM(macOS)으로 진행했지만, 이후 nested-virt 설정 자동화와 한 줄 부팅 wrapper 구현을 위해 Apple Virtualization framework를 직접 활용하는 Lima로 전환했습니다. 이 글의 환경은 Lima 기반입니다.
1·2부 두 글의 시점에는 아직 풀리지 않은 영역들이 있었습니다.
| 영역 | 당시 상태 |
| cinder block storage (volume create + VM attach) | backend 비활성 |
| 게스트 VM 안에서 외부 인터넷 | vmnet 한계로 추정 — X |
| host VM 재부팅 후 자동 회복 | 첫 부팅만 검증 |
| 호스트 Mac → 게스트 floating IP | vmnet shared 한계 |
이번 3부는 이 영역들을 하나씩 다시 파고든 기록입니다. 결론부터 말하면, "호스트 Mac → floating IP" 한 영역을 제외한 모든 항목이 풀렸습니다. 그리고 대부분의 원인은 단일 VM의 한계가 아니었습니다.
2. "안 됨"으로 봤던 것들의 실제 원인
2-1. 게스트 DHCP IP 획득 — chart bug
qdhcp namespace plumbing 한계로 추정했던 DHCP 미응답의 실제 원인은 upstream openstack-helm chart의 dhcp-agent template에서 /run/openvswitch hostPath mount가 누락된 chart bug였습니다. ovs-agent template에는 있는데 dhcp-agent에만 빠져 있었고, chart values에서 pod.mounts override 한 줄로 해소됐습니다.
이 발견의 의미는 단순합니다. 멀티노드 환경에서도 같은 chart를 그대로 쓰면 같은 issue를 만납니다. "단일 VM이라서 안 된다"는 결론은 틀렸습니다.
2-2. 호스트→VM ssh — 추가한 systemd 설정 실수
"단일 NIC 한계"로 봤던 영역도, 실제로는 이전에 추가한 systemd unit의 Type=oneshot 설정이 부팅 순서를 막아 cloud-init이 실행되지 못한 것이었습니다. Type=simple로 변경해 해소됐습니다.
2-3. 게스트 → 외부 인터넷 — dead default route
vmnet shared의 outbound 한계로 봤지만, 실제로는 sandbox 호스트의 default route가 Lima 내부 dummy gateway에 더 낮은 metric으로 잡혀 있어 eth0의 real gateway가 무시되는 것이었습니다. 시작 스크립트에서 dead default route를 제거하니 풀렸습니다.
3. 가장 오래 걸린 영역 — cinder block storage
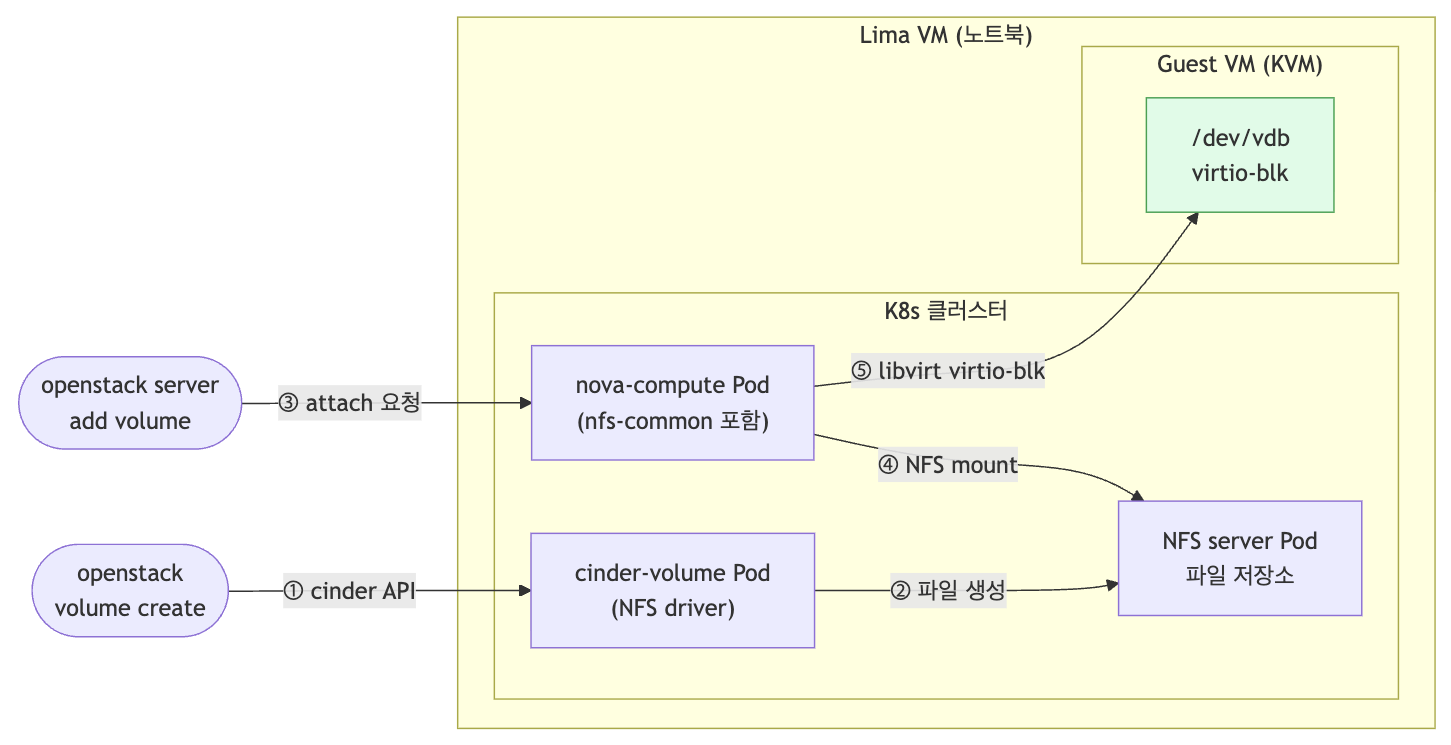
이 영역이 가장 복잡했습니다.
운영 환경과의 정합을 위해 ceph RBD 방식을 먼저 시도했습니다. 그러나 빌드 시점 IP가 K8s internal state (etcd 포함)에 hardcoded되는 문제로 부팅 후 검증에서 실패했습니다. ceph mon의 host 주소가 빌드 시점 IP로 고정되어 있어, 다른 네트워크에서 부팅하면 연결 자체가 불가능했습니다.
결과적으로 NFS 방식이 정공이 됐습니다.
cinder NFS는 file-based driver지만, 실제 attach 시점에 nova-compute가 NFS를 호스트에 mount하고 그 위의 파일을 libvirt가 게스트의 virtio-blk로 attach하는 구조입니다. 게스트 안에서는 block device /dev/vdb로 보입니다.
남은 문제는 nova-compute Pod에 mount.nfs가 없다는 것이었습니다. upstream nova 이미지에 nfs-common을 추가한 thin layer 이미지를 사내 Harbor에 push하고, chart values에서 nova-compute image를 override하는 패턴으로 해소했습니다.
4. 발견한 함정 — upstream chart의 daily image republish
cinder를 풀어가는 과정에서 예상치 못한 함정을 하나 더 만났습니다.
어느 날 정상 동작하던 keystone db-init Job이 다음 날 빌드에서 ModuleNotFoundError: No module named 'pymysql'로 CrashLoop에 빠졌습니다. chart version은 동일, image tag도 동일했습니다.
원인은 같은 tag에 매일 다른 image가 push되는 quay.io의 daily build 패턴이었습니다. 하루 사이에 republish된 image에서 pymysql 패키지가 빠진 상태로 나왔고, 다음 빌드가 그걸 그대로 가져간 것입니다.
image digest pinning을 시도했으나, Quay registry의 garbage collection으로 이전 digest는 1일 이내에 영구 삭제됩니다. daily build 레지스트리에서 digest pinning은 의미가 없습니다.
임시 우회로 chart values의 db_init/db_drop image를 openstack-client → 각 service image (keystone/glance/...)로 변경했습니다. service image에는 pymysql이 포함되어 있어서 정상 동작합니다. 근본 해결은 사내 Harbor에 mirror push하여 외부 레지스트리 daily build의 직격을 차단하는 것입니다.
참고: 이 image에 pymysql이 빠진 채로 publish됐다는 건 chart 기본 image 선택이 우리 환경과 맞지 않는 부분이기도 합니다. 운영 환경은 mariadb-operator의 Database CRD로 chart의 db_init Job 자체를 비활성화하기 때문에 영향을 받지 않지만, sandbox는 단순화를 위해 chart Job을 살리는 구조라 직격을 받았습니다.
5. 최종 검증 — reboot에서도 살아남는다
위 영역이 모두 풀린 시점에서, reboot 안정성을 검증하기 전에 한 가지 이슈를 먼저 잡아야 했습니다. containerd v2.2의 strict validation에서 mirrors와 config_path = ''가 동시에 설정되면 kubelet의 CRI 연결이 끊기는 문제였습니다. config_path = /etc/containerd/certs.d + 분산 hosts.toml 패턴으로 변경하여 해소한 뒤 종단 시나리오를 돌렸습니다.
# 1. cinder NFS volume 생성 → VM에 attach
$ openstack volume create --size 1 --type nfs-1 demo-vol     # → available 1초
$ openstack server add volume demo-vm demo-vol               # → in-use, /dev/vdb

# 2. 게스트 안 IO 무결성
$ ssh ubuntu@$FIP '
  sudo mkfs.ext4 -F /dev/vdb && sudo mount /dev/vdb /mnt/voltest
  sudo dd if=/dev/urandom of=/mnt/voltest/test.bin bs=1M count=10
  sudo md5sum /mnt/voltest/test.bin    # → 093904aab02fbcd4dbd845adeb00876e
  sudo umount /mnt/voltest && sudo mount /dev/vdb /mnt/voltest
  sudo md5sum /mnt/voltest/test.bin    # → 093904aab02fbcd4dbd845adeb00876e  ✓
'

# 3. host VM 재부팅
$ limactl stop sandbox && limactl start sandbox

# 4. 재부팅 후 데이터 무결성
$ ssh ubuntu@$FIP 'sudo mount /dev/vdb /mnt/voltest; sudo md5sum /mnt/voltest/test.bin'
  # → 093904aab02fbcd4dbd845adeb00876e  ✓ 재부팅 전과 일치
호스트 재부팅 후에도 cinder NFS volume의 데이터 무결성이 보존됩니다.
재부팅 후 일부 hand-fix가 있습니다.
- cinder-volume
down: NFS server Pod이 Ready 되기 전에 cinder-volume이 mount를 시도하는 race condition.kubectl rollout restart deploy/cinder-volume-nfs1줄로 복구.
- Lima의
sudo reboot미인지: Lima hostagent가 guest의 sudo reboot을 인지하지 못하고 옛 IP/포트로 SSH를 시도합니다. 사용자에게는limactl stop sandbox && limactl start sandbox사용을 안내합니다.
이 hand-fix들은 NFS server Ready dependency 명시 + pre-stop hook 도입으로 자동화 가능하며, 이후 작업으로 남겨두었습니다.
6. 운영 정합성 — 단일 VM이지만 운영 미니어처
| 영역 | 운영 환경 | sandbox |
| 노드 토폴로지 | 멀티노드 | 단일 VM |
| K8s CNI + neutron ML | kube-ovn 통합 | flannel + ML2/OVS |
| Cinder backend | block storage | NFS (file-based, 게스트에서는 block) |
| MariaDB | mariadb-operator (Database CRD) | mariadb chart (StatefulSet) |
| GitOps | ArgoCD + Flux | ArgoCD + Flux |
| Secret 흐름 | Vault + ESO | Vault + ESO |
backend driver의 차이는 cinder.conf 한 줄입니다. GitOps 흐름과 Secret 관리 방식은 운영과 동일합니다. sandbox에서 검증한 OpenStack API client 코드는 운영에 그대로 가져갈 수 있습니다.
7. 닫는 말
돌아보면, "단일 VM이라서 안 된다"고 봤던 영역 대부분의 실제 원인은 chart dhcp-agent template의 hostPath 누락이었거나, upstream image에서 pymysql 패키지가 빠진 채로 재배포된 것이었거나, 직접 추가한 systemd unit의 설정 실수였습니다. 단일 VM이 본질적으로 막는 영역은 "호스트 Mac → 게스트 floating IP" 하나뿐이었고, 나머지는 멀티노드에서도 동일하게 마주칠 문제입니다.
개발자 입장에서 이 sandbox가 주는 것은 단순합니다. 노트북에서 openstack server create, openstack volume create, openstack server add volume을 직접 실행해볼 수 있고, 작성한 OpenStack API 코드는 운영 환경에 그대로 가져갈 수 있습니다. GitOps와 Secret 관리 흐름도 운영과 동일합니다.
cinder backend API 직접 호출, Manila(공유 파일시스템), Octavia(로드밸런서)는 단일 VM 구조에서 검증하기 어려운 영역으로, 멀티노드 환경에서 이어가겠습니다. 아직 실험적인 단계이고 부족한 부분도 있지만, 진행되는 내용이 생길 때마다 실사례 중심으로 공유하겠습니다.
자주 묻는 질문 FAQ
관련 / 출처 REFERENCES