
요약 SUMMARY
북미 AI 데이터센터의 전력 밀도와 배전·액체냉각 인프라를 어떻게 변화시켰는지 다룹니다.
고밀도 GPU 환경에 필요한 인프라 설계 방향과 설비 노후화 리스크를 정리합니다.
#NVIDIA #GPU로드맵 #AIDC #전력밀도 #액체냉각
1. 실리콘의 한계가 인프라의 임계점으로
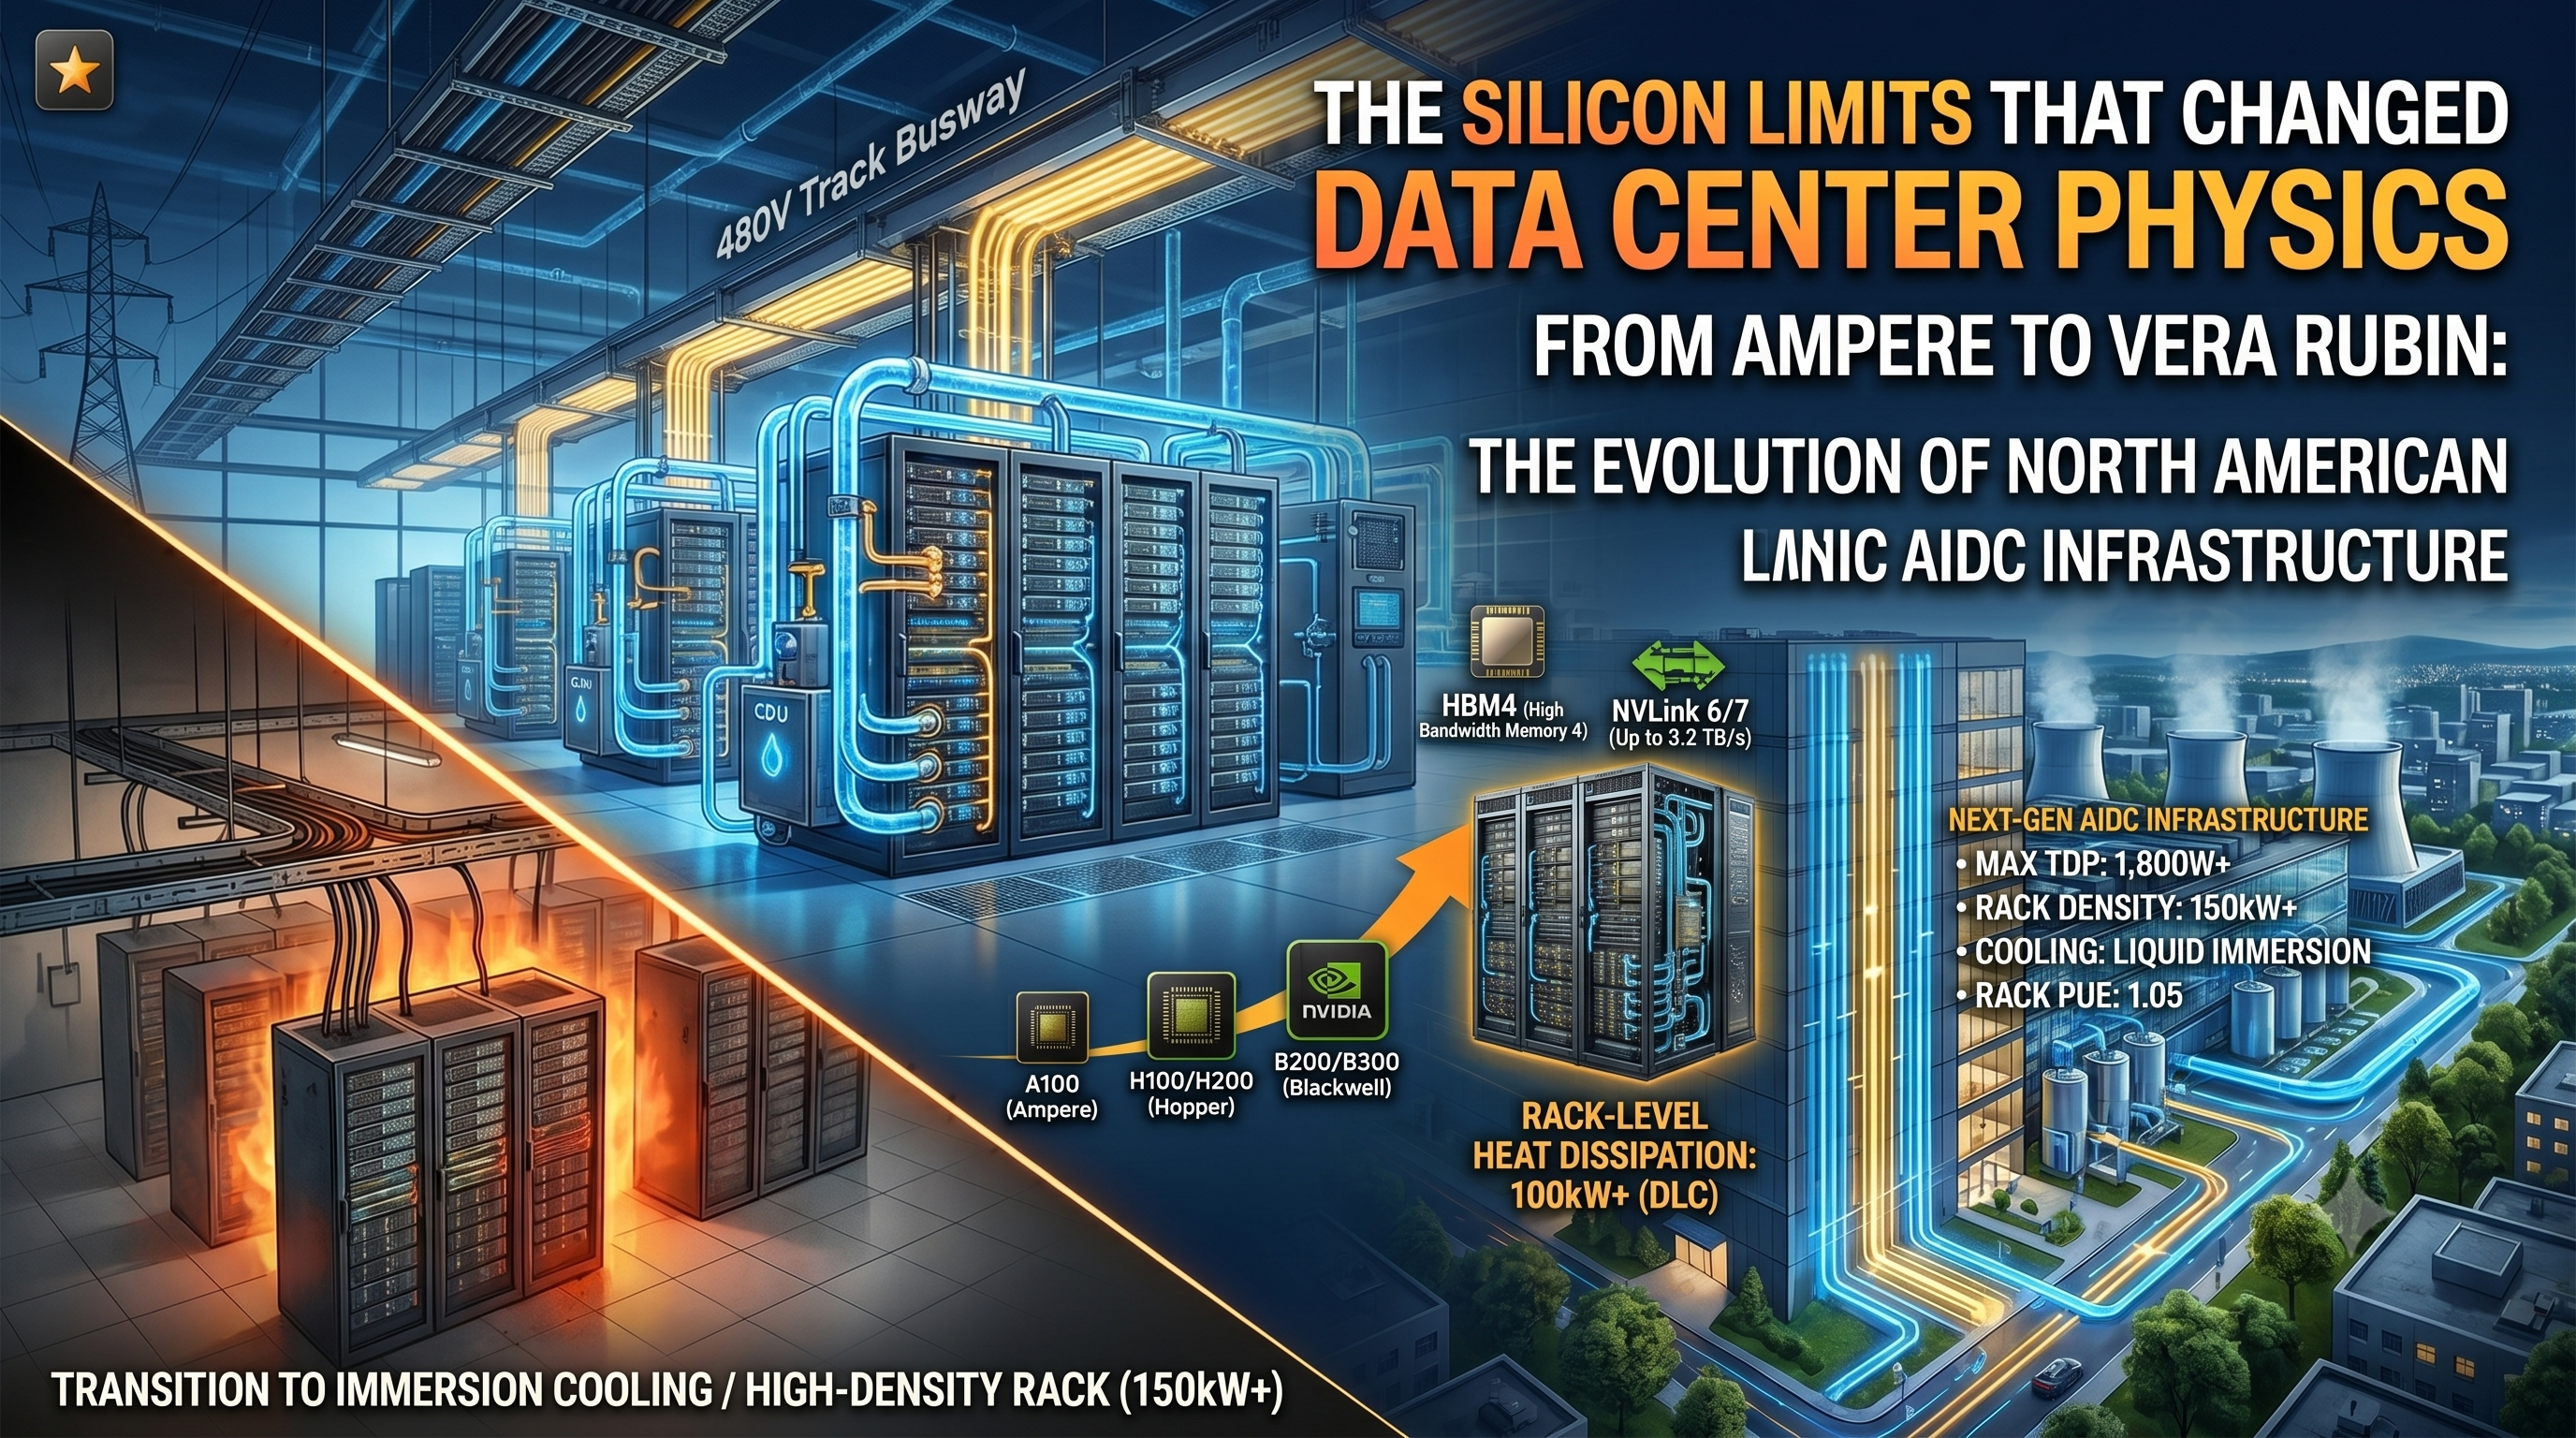
무어의 법칙(Moore's Law)이 종말을 고하고, 단일 칩 수준의 미세 공정 전환 속도가 둔화함에 따라 반도체 업계는 다이(Die)를 쪼개어 붙이는 칩렛(Chiplet) 구조와 극단적인 가속 컴퓨팅 아키텍처로 방향을 선회했습니다. 이 변화의 최전선에 서 있는 하드웨어가 바로 거대언어모델(LLM)과 생성형 AI 연산의 심장인 GPU입니다. 하지만 트랜지스터 밀도의 수직 상승과 다이 사이즈의 확장은 필연적으로 칩 한 개가 소모하는 열설계전력(TDP)의 폭발적인 증가를 수반했습니다.
이러한 실리콘 수준의 로드맵 변화는 소프트웨어를 담는 단순 부동산 공간이었던 과거의 데이터센터를, 하드웨어와 고전압 전력 공학 및 열역학이 유기적으로 결합된 시스템 엔지니어링 룸인 'AI 데이터센터(AIDC)'로 진화시켰습니다. 특히 전 세계 하이퍼스케일 트렌드를 선도하는 북미 시장의 글로벌 CSP(Cloud Service Provider) 및 빅테크 기업들은 수만 장의 GPU를 하나의 거대한 가속기 풀(Pool)인 초거대 클러스터로 묶는 과정에서 기존 공랭식 인프라가 가진 물리적 법칙의 한계에 직면하게 되었습니다(U.S. Department of Energy, 2026).
2. GPU 가속 로드맵과 랙당 전력 밀도의 상관관계
지난 수년간 엔비디아가 발표한 GPU 아키텍처의 세대별 변화를 분석해 보면, 데이터센터 인프라 엔지니어들이 마주한 '전력 밀도'와 '발열량'의 압박이 얼마나 급격하고 파괴적인 속도로 진행되었는지 명확히 파악할 수 있습니다.
| GPU 세대 (아키텍처) | 대표 모델 | 출시(예정) | 단일 GPU 최대 TDP | 표준 서버 랙당 전력 밀도 | 지배적인 냉각 아키텍처 |
| Ampere | A100 | 2020년 | 400W | 10 kW ~ 15 kW | 일반 공랭식 (Air-Cooled, 항온항습기 중심) |
| Hopper | H100 / H200 | 2022~2024년 | 700W ~ 1,410W | 30 kW ~ 40 kW | 하이브리드 (공랭 + RDHx 후면 냉각 코일) |
| Blackwell | B200 / B300 | 2024~2025년 | 1,020W ~ 1,200W | 60 kW ~ 100 kW (NVL72) | 직접액체냉각 (DLC, Direct-to-Chip) 표준 필수화 |
| Rubin | Vera Rubin | 2026년 (예정) | 1,500W+ 추정 | 120 kW ~ 140 kW | 고도화된 DLC + 루프형 다중 매니폴드 체계 |
| Rubin Ultra | Rubin Ultra | 2027년 (예정) | 1,800W+ 추정 | 150 kW+ 이상 | 액침 냉각(Immersion Cooling) 및 특수 유체 냉각 |
2.1 Ampere에서 Hopper로: 공랭 엔지니어링의 구조적 종말
2020년 도입된 Ampere 아키텍처 기반의 A100 GPU는 단일 칩 기준 TDP가 최대 400W 수준으로, 보편적인 8Way 서버 설계 시 랙당 전력 소모량이 10kW에서 15kW 내외에 머물렀습니다. 이는 기존 하이퍼스케일 데이터센터가 전통적으로 채택해 온 차가운 공기와 뜨거운 공기를 물리적으로 격리하는 컨테인먼트(Aisle Containment) 구조와 고풍량 바닥 공조 시스템을 통해 충분히 방열할 수 있는 상한선이었습니다.
그러나 Hopper(H100/H200) 세대에 이르러 상황은 반전되었습니다. 단일 칩의 TDP가 700W로 두 배 가깝게 급증했고, 고대역폭 메모리(HBM3)와 초고속 Interconnect 아키텍처가 단일 서버 섀시에 밀집되면서 랙당 요구 전력이 30kW에서 40kW에 육박하게 되었습니다. 기체인 공기는 비열과 열전도율이 극도로 낮기 때문에, 40kW의 열밀도를 공기로만 식히려면 서버 내부에 장착된 배출 팬의 RPM을 물리적 한계까지 끌어올려야 합니다. 이는 팬 자체가 소비하는 기생 전력(Parasitic Power)의 기하급수적인 증가를 불러왔으며, 전력 보존 법칙의 역설을 낳았습니다. 이 시기 북미 엔지니어들은 기존 데이터센터 구조를 전면 개축하는 대신, 랙 후면에 냉각수가 흐르는 라디에이터를 장착하는 후면 냉각 코일(RDHx, Rear Door Heat Exchanger)을 도입하며 하이브리드 형태로 공랭의 수명을 간신히 연장시켰습니다.
2.2 Blackwell에서 Vera Rubin까지: 수냉(Liquid Cooling)으로의 불가역적 대전환
2024년과 2025년을 기점으로 상용화된 Blackwell(B200, B300) 아키텍처는 데이터센터 인프라 아키텍처를 완전히 바꾼 이정표입니다. 블랙웰 단일 칩은 무려 1,000W에서 1,200W에 달하는 전력을 소모하며, 72개의 GPU를 엔비디아의 초고속 NVLink 5로 전면 통합한 Blackwell NVL72 아키텍처의 경우 단일 랙이 요구하는 전력 밀도가 100kW에 도달합니다. 이는 일반적인 도심형 오피스 빌딩 한 개 층 전체가 소비하는 전력량과 맞먹는 수준입니다.
단일 랙 100kW의 시대에서 공랭식 설계는 완벽히 불가능해집니다. 공기로 이 정도의 열유속(Heat Flux)을 제어하려면 초속 수십 미터의 음속에 가까운 태풍급 강풍을 상시 불어넣어야 하므로 배보전 효율이 마이너스로 돌아서기 때문입니다. 이에 따라 엔비디아는 Blackwell 제품군부터 직접액체냉각(DLC, Direct-to-Chip)을 표준 하드웨어 규격으로 규정했습니다(NVIDIA Corporation, 2026). 나아가 차세대 Vera Rubin(베라 루빈) 및 Rubin Ultra 로드맵은 HBM4 메모리의 하이브리드 본딩 인터페이스 채택과 3나노 이하 극미세 공정의 한계 구동으로 인해 단일 칩 TDP가 1,500W~1,800W를 돌파할 것으로 확인됩니다. 이로 인한 표준 클러스터 랙의 밀도는 140kW~150kW 이상으로 수직 상승하며, 단순한 유체 순환을 넘어 분당 수백 리터의 유량을 정밀 제어하는 유체역학 파이프라인 설계가 AIDC 인프라 사업자의 핵심 경쟁력이 되었습니다.
3. 북미 하이퍼스케일 데이터센터의 공학적 변화상
실리콘 집적도의 폭발적인 변화를 수용하기 위해, 버지니아(Ashburn), 오레곤(Prineville), 텍사스 등 북미의 하이퍼스케일 인프라 벨트는 전력 인입 시스템과 변전 계통, 그리고 내부 기계 설비 루프를 근본부터 완전히 재설계하고 있습니다.
3.1 전력 계통의 혁신: 480V 고압 직결 배전과 천장형 트랙 버스웨이(Track Busway)
전통적인 하이퍼스케일 데이터센터는 Grid 변전소로부터 초고압 전력을 수전받은 뒤, 다단계 변압기를 통해 최종 서버 랙 단에서 208V 또는 240V 교류(AC) 전압으로 감압하여 인입했습니다. 하지만 랙당 전력 밀도가 100kW 이상으로 올라간 환경에서 기존의 240V 전압을 고수할 경우, 줄의 법칙 및 옴의 법칙($P = VI$)에 따라 랙 하나에 흐르는 전류($I$)가 수백 암페어(A) 단위로 치솟게 됩니다. 고전류가 흐르면 구리 전선의 굵기가 물리적으로 지나치게 두꺼워져 서버 내부 실장 공간을 차단할 뿐만 아니라, 전선 자체의 고유 저항으로 인한 열 손실($P_{loss} = I^2R$)이 전류의 제곱에 비례해 증가하므로 데이터센터 내부의 화재 위험성이 극대화됩니다.
이를 엔지니어링적으로 극복하기 위해 북미의 최신 AIDC들은 서버 랙 내부에 변압 단계를 축소하고 480V 고압 배전 체계를 직접 인입하는 전력 설계를 전면 적용했습니다. 공급 전압을 배로 높임으로써 필요한 전류량을 낮춰 전선 두께를 대폭 줄이고 송전 효율을 극대화한 것입니다. 더불어, 복잡한 구리 전선 다발을 바닥이나 벽면에 가설하던 과거 방식에서 탈피하여, 천장에 일체형 구리 막대 블록 체계인 트랙 버스웨이(Track Busway) 시스템을 가설하고 있습니다. 이를 통해 수백 장의 GPU 서버 랙이 유동적으로 증설되거나 레이아웃이 변경되더라도 플러그인 탭을 매설된 구리 바에 꽂는 것만으로도 수십 kW급의 고안정성 전류를 즉각 분배할 수 있는 '전력의 혈관화'를 완성했습니다.
3.2 냉각 루프의 대전환: 메가와트급 CDU(Coolant Distribution Units)와 유체 제어 공학
Blackwell과 차세대 Vera Rubin 클러스터가 구축된 북미 메가 캠퍼스 내부의 가장 큰 특징은 공조 팬의 굉음이 사라지고, 거대한 기계식 유체 관로가 그 자리를 대체했다는 점입니다. 직접액체냉각(DLC) 시스템의 핵심은 GPU 및 부속 칩셋 위에 열전도율이 극대화된 특수 구리 합금 기반의 콜드 플레이트(Cold Plate)를 완벽히 밀착시키고, 그 내부의 미세 가공된 수로(Micro-channels) 속으로 냉각수를 끊임없이 순환시키는 메커니즘입니다.
이 액체 순환 체계의 두뇌이자 심장 역할을 수행하는 설비가 바로 냉각분배장치(CDU, Coolant Distribution Unit)입니다. CDU는 데이터센터 외부의 거대 냉각탑 및 칠러(Chiller)와 연결되어 산업용 냉각수가 흐르는 '1차 루프(Primary Loop)'와, 오염 물질และ 이온이 전면 제거되어 실제 GPU 칩 표면을 정밀 타격하는 탈이온수(Deionized Water) 기반의 '2차 루프(Secondary Loop)' 사이에서 독립적인 열교환(Heat Exchange)을 수행합니다(ASHRAE, 2025). 북미의 하이퍼스케일 센터들은 랙 내부나 유휴 공간에 메가와트(MW)급 열량을 상쇄할 수 있는 고성능 CDU를 촘촘히 배치하고 있습니다. 만약 2차 루프 파이프라인 내부에서 순환 압력 평형이 무너지거나 미세한 와류가 발생하여 유량이 정체될 경우, 수천만 원을 호가하는 엔비디아 Blackwell/Rubin 칩은 단 2~3초 만에 최대 동작 임계 온도를 초과하여 열폭주(Thermal Throttling)를 일으키고 시스템 다운 또는 실리콘 소자 격파로 이어질 수 있습니다. 이 때문에 고도의 밸브 유체 제어 엔지니어링과 압력 센싱 자동화 기술이 인프라 설계의 본질이 되었습니다.
4. 하드웨어 로드맵이 인프라 사업자에게 던지는 명암
글로벌 인프라 시장에서 빅테크 기업들이 북미 전역 및 아시아 거점에 기존의 수십 MW 단위를 넘어 기가와트(GW)급 메가 캠퍼스 부지를 공격적으로 선점하려는 배경에는 하드웨어의 미친듯한 진화 속도가 물리 공간의 전통적 토목/건축 속도를 압도하고 있다는 구조적 모순이 존재합니다.
전통적인 데이터센터 산업에서는 한번 건물을 완공하면 최소 10년에서 15년 동안 내부 기계 및 전력 설비의 대대적인 변경 없이 표준 서버 하드웨어만 주기적으로 슬롯 교체(Tech Refresh)하며 감가상각을 진행하는 것이 비즈니스 모델의 기본 공식이었습니다. 그러나 AI 시대의 도래 이후, 불과 2년 단위로 GPU 아키텍처가 Ampere에서 Hopper로, 다시 Blackwell과 차세대 Vera Rubin으로 급속도로 축나면서, 인프라의 하드웨어 수용 스펙이 실리콘 기술의 진화를 제때 받쳐주지 못하면 글로벌 CSP나 대형 AI 연구소들로부터 외면받는 '자산의 노후화' 리스크가 도래했습니다(The Green Grid, 2025).
5. 디지털 지능을 창조하는 열역학적 발전소
Ampere 아키텍처의 A100에서 출발한 초거대 AI 인프라의 여정은 이제 Vera Rubin과 Rubin Ultra라는 인간의 뇌신경망 연산 규모에 필적하는 초고속 컴퓨팅 영역을 향해 가속 페달을 밟고 있습니다. 전 세계 인류가 프롬프트 창에 입력하는 질문 한 줄과 이에 대응해 쏟아지는 수조 개의 디지털 토큰(Token)들은 스크린 위의 가상 비트(Bit)처럼 보이지만, 본질적으로는 AIDC 내부에서 480V 버스웨이의 전력을 아낌없이 연소시키고 메가와트급 CDU의 액체 냉각 루프를 쉼 없이 가동하여 물리적 열역학 한계를 매 순간 돌파해 낸 엔지니어링의 위대한 산물입니다.
향후 글로벌 AI 인프라 시장의 최종 승자는 소프트웨어 알고리즘의 최적화 능력을 넘어, 세대별 GPU 하드웨어 로드맵이 내뿜는 극한의 열밀도를 가장 효율적이고 경제적인 비용(PUE 1.1 이하)으로 정교하게 제어할 수 있는 '하드웨어 공학 리더십'을 갖춘 사업자가 될 것입니다. 물리적 인프라는 이제 더 이상 조연이 아니며, 인류의 새로운 디지털 지능을 실시간으로 주조해 내는 거대한 열역학적 발전소이자 공학의 총체입니다.
자주 묻는 질문 FAQ
관련 / 출처 REFERENCES
- NVIDIA Corporation. (2024-2026). NVIDIA Blackwell Bedrock: Transforming the Data Center Infrastructure for Next-Generation AI . NVIDIA Technical Whitepaper.
- NVIDIA Corporation. (2025). Advancing Next-Generation Computing: From Blackwell to the Vera Rubin Architecture . NVIDIA Investor Day & Tech Progress Report.
- U.S. Department of Energy (DOE). (2026). Energy Efficiency and Thermal Management Challenges in Exascale and AI Hyper-Density Data Centers . Office of Energy Efficiency & Renewable Energy.
- The Green Grid. (2025). Data Center Maturity Model (DCMM): Navigating the High-Density AI Infrastructure Refresh . White Paper #82.
'Tech Story > Tech Inside' 카테고리의 다른 글
| [인사이트] AI 트랜스포메이션의 진짜 병목은 어디인가? 네트워크 인프라가 맞이한 거대한 지각변동 (0) | 2026.10.27 |
|---|---|
| [인사이트] 로봇은 왜 챗봇과 GPU 수요가 다를까? 피지컬 AI 시대의 인프라 전략 (0) | 2026.10.21 |
| [분석] DDoS 환경에서 OVS kernel datapath 성능 붕괴 (0) | 2026.10.14 |
| [인사이트] GPUaaS 네트워크 경쟁 구조 분석 (0) | 2026.10.08 |
| [기술분석] AI 추론 메모리 병목과 서버 아키텍처 변화 (1) | 2026.09.23 |